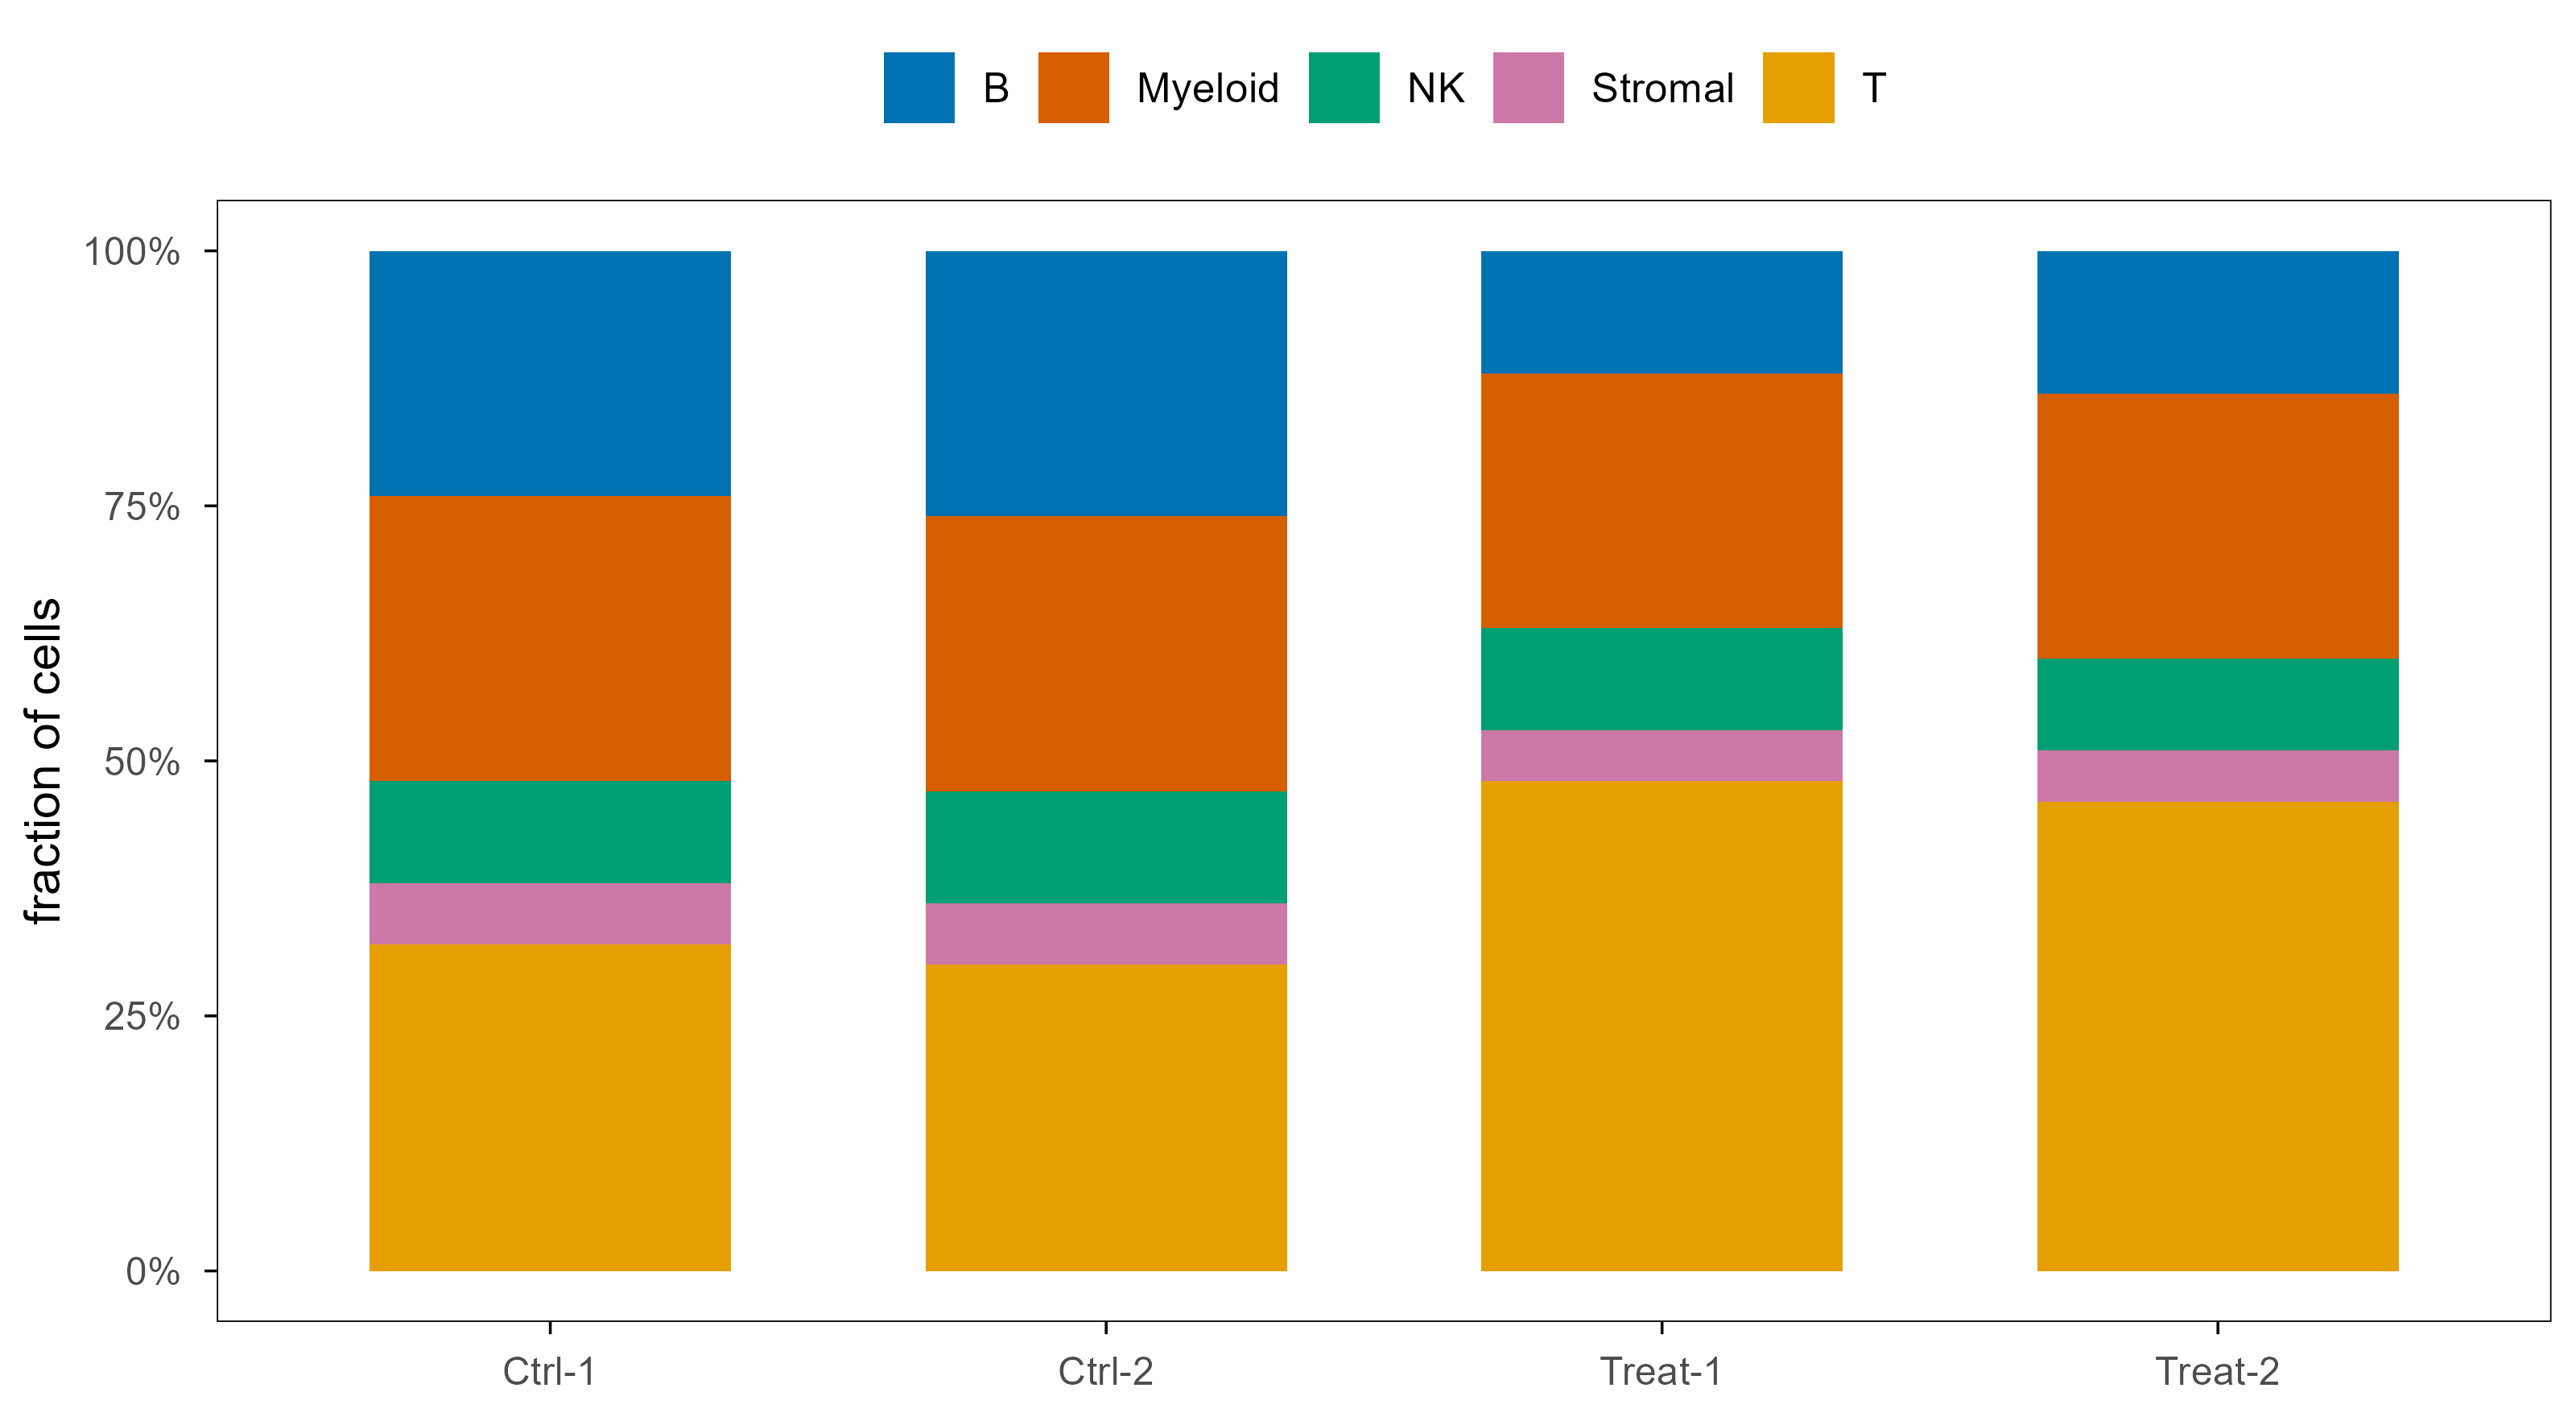本文由 DeepSeek-Flash 生成,尚未经过人工校对 ,可能存在事实、数字或表述上的错误,请以原始文献和官方文档为准。
文中的测序原理、流程和常见问题来自公开文档与文献;所有图表均由本文的 R 代码在渲染时生成,其中的数据是为了说明概念而模拟的 ,不代表任何真实样本的测量结果。
单细胞测序(single-cell sequencing)已经成了生物医学的默认工具,但第一次拿到数据时的困惑往往非常具体:一个细胞到底被测成了什么?BCL、FASTQ、BAM、matrix.mtx、h5ad 这些文件分别是什么?FASTQ 里那一行行字母和这个细胞有什么关系?为什么最后只剩下一个稀疏矩阵?
这篇文章按数据实际流动的顺序,把整条链路拆开讲:分子层面的捕获与建库 → 平台选择 → 原始文件格式 → 条码与 UMI 处理 → count matrix → 质控 → 标准化与降维 → 聚类与注释 → 细胞状态分析 → 下一轮实验设计。目标是写成一份可以按图索骥的技术报告,而不是概念综述。
1. 单细胞测的是什么
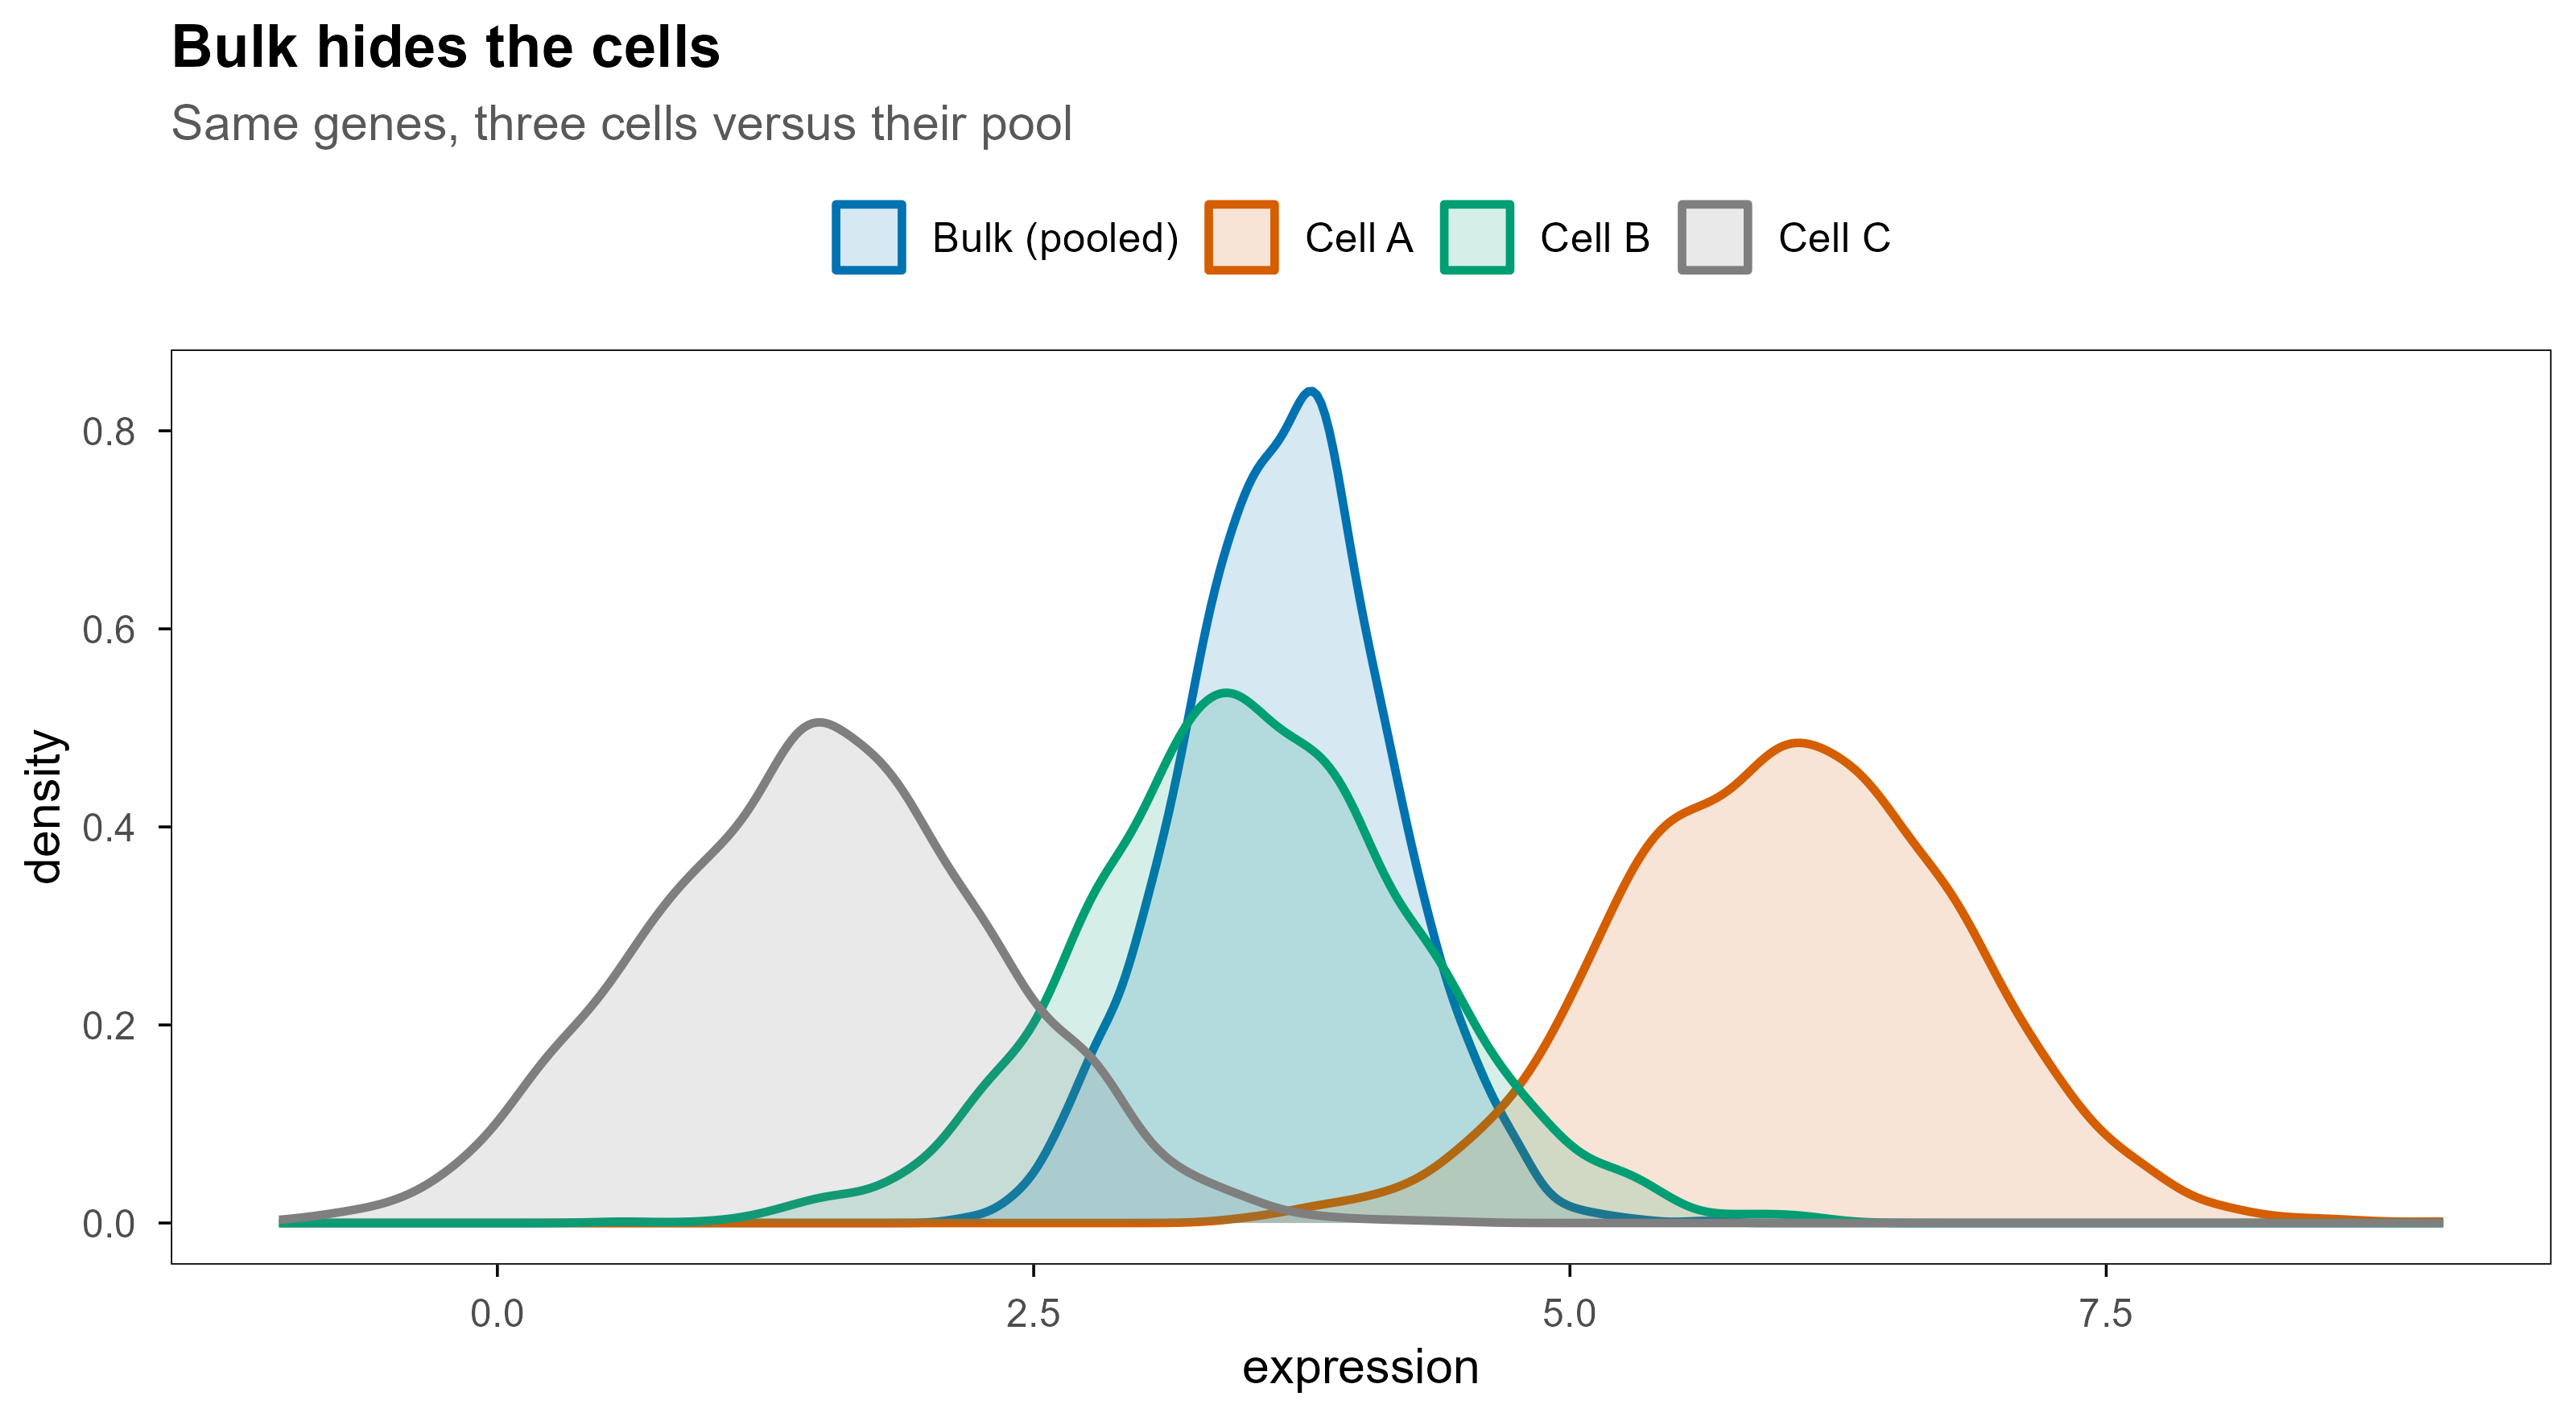
Bulk RNA-seq 测的是一管组织里所有细胞混在一起的平均值。平均会抹掉两件最重要的事:细胞之间的差异 ,以及稀有细胞的存在 。
<- 2000 <- bind_rows (data.frame (cell = "Cell A" , expr = rnorm (n_genes, 6.0 , 0.8 )),data.frame (cell = "Cell B" , expr = rnorm (n_genes, 3.5 , 0.8 )),data.frame (cell = "Cell C" , expr = rnorm (n_genes, 1.5 , 0.8 ))<- data.frame (cell = "Bulk (pooled)" ,expr = rowMeans (matrix (sc$ expr, ncol = 3 )) + rnorm (n_genes, 0 , 0.15 )ggplot (bind_rows (sc, bulk), aes (expr, colour = cell, fill = cell)) + geom_density (alpha = 0.16 , linewidth = 0.9 ) + scale_colour_manual (values = c (pal[1 : 3 ], blog_pal[["grey" ]])) + scale_fill_manual (values = c (pal[1 : 3 ], blog_pal[["grey" ]])) + labs (x = "expression" , y = "density" , colour = NULL , fill = NULL ,title = "Bulk hides the cells" ,subtitle = "Same genes, three cells versus their pool"
单细胞测序把“平均”拆回“个体”:每个细胞一个表达向量。由此才能回答三类问题:
组成 :这份组织里有哪些细胞类型?比例是多少?病人和对照之间比例是否改变?状态 :同一类型的细胞是否处在不同状态(激活、耗竭、周期、应激)?关系 :细胞之间的谱系关系、通讯关系、与空间位置的关系。
代价是每个细胞的测量变得又浅又噪声大:一个细胞通常只有几千到几万个 UMI,一个基因经常是 0。所以单细胞分析的很大一部分工作,是在稀疏、噪声、技术偏差 之上做统计推断。
2. 分子层面:一个 mRNA 如何变成一条 read
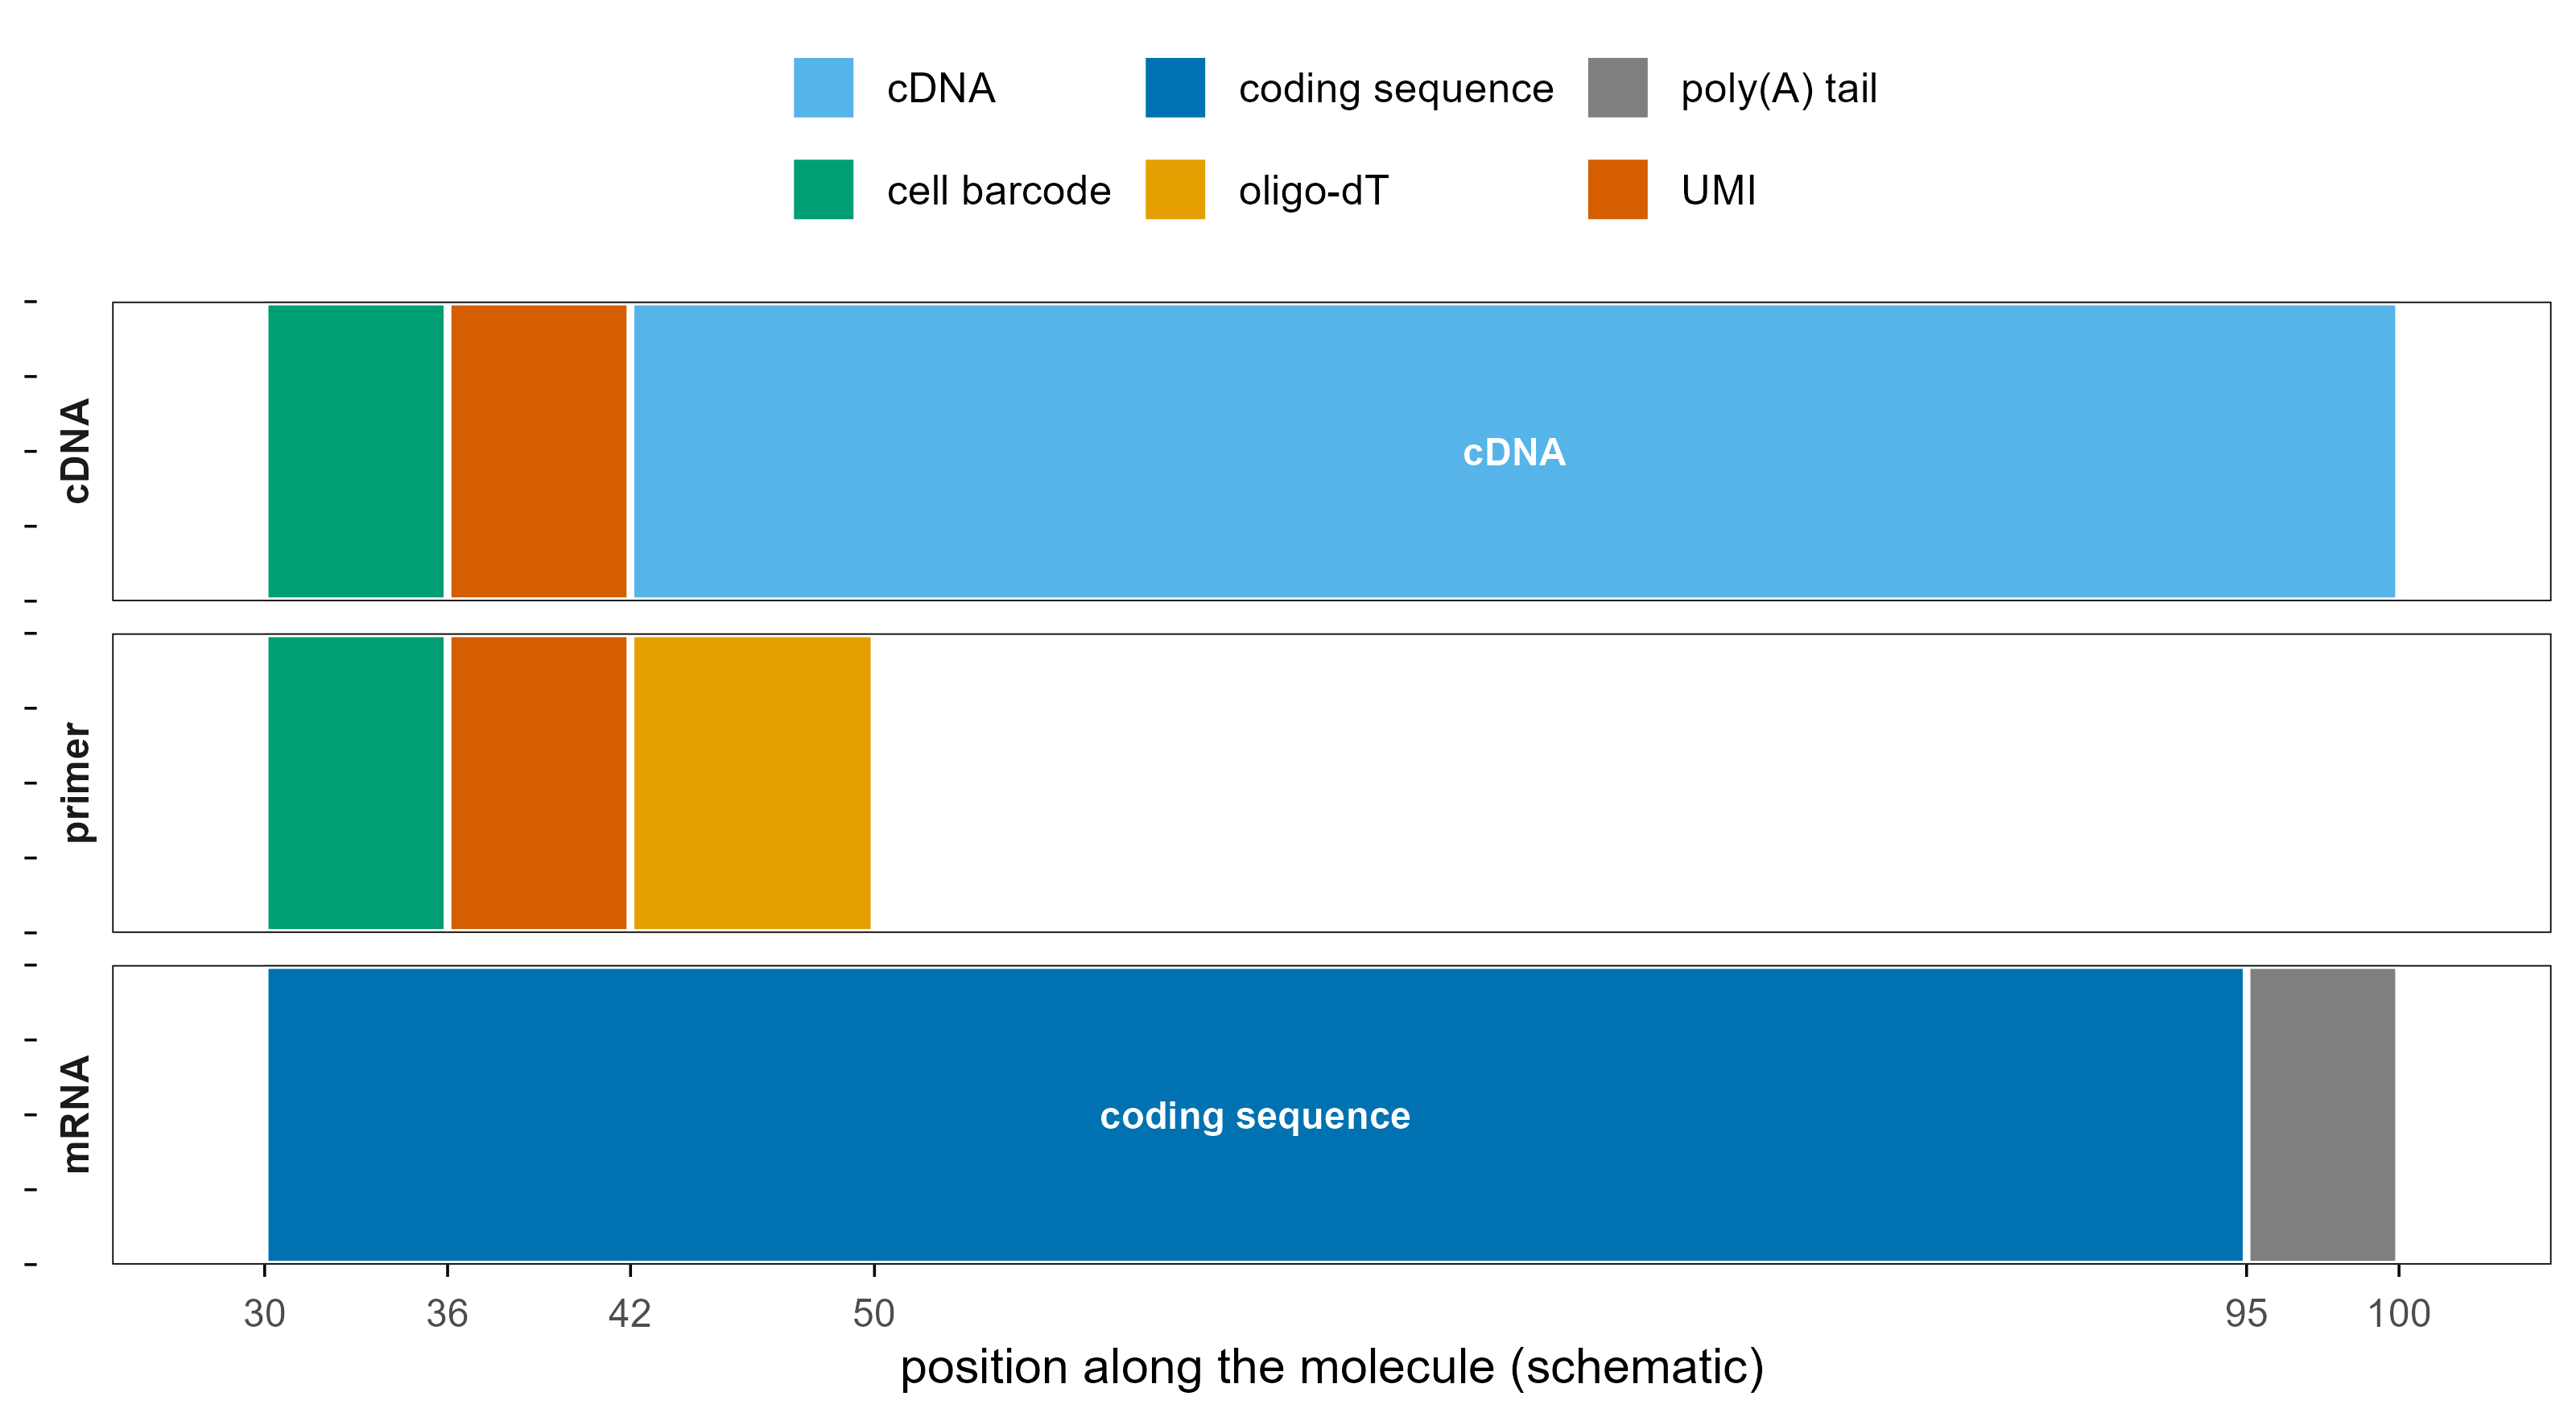
不同的平台细节不同,但绝大多数 scRNA-seq 都遵循同一套化学逻辑:
捕获 mRNA :利用 mRNA 3’ 端的 poly(A) 尾巴,用 oligo-dT 引物反转录。这一步决定了 3’ 偏好。打标签 :oligo-dT 引物上带有细胞条码(cell barcode)和分子标签(UMI)。同一个细胞的所有 cDNA 共享同一段条码;同一个原始 mRNA 分子的所有 PCR 拷贝共享同一个 UMI。反转录与模板转换 :加入模板转换寡核苷酸(TSO),在 cDNA 3’ 端加上已知序列,便于后续扩增。扩增与建库 :cDNA 扩增、片段化、加接头、测序。10x 只测一端(3’ 或 5’),Smart-seq 测全长。
<- data.frame (molecule = factor (c ("mRNA" , "mRNA" , "primer" , "primer" , "primer" , "cDNA" , "cDNA" , "cDNA" ),levels = c ("cDNA" , "primer" , "mRNA" )start = c (30 , 95 , 30 , 36 , 42 , 30 , 36 , 42 ),end = c (95 , 100 , 36 , 42 , 50 , 36 , 42 , 100 ),feature = c ("coding sequence" , "poly(A) tail" , "cell barcode" , "UMI" , "oligo-dT" ,"cell barcode" , "UMI" , "cDNA" ggplot (mol) + geom_rect (aes (xmin = start, xmax = end, ymin = 0 , ymax = 1 , fill = feature),colour = "white" , linewidth = 0.8 + geom_text (data = subset (mol, end - start >= 25 ),aes (x = (start + end) / 2 , y = 0.5 , label = feature),size = 3 , colour = "white" , fontface = "bold" + facet_wrap (~ molecule, ncol = 1 , strip.position = "left" ) + scale_fill_manual (values = c ("coding sequence" = blog_pal[["blue" ]],"poly(A) tail" = blog_pal[["grey" ]],"cell barcode" = blog_pal[["green" ]],"UMI" = blog_pal[["vermillion" ]],"oligo-dT" = blog_pal[["orange" ]],"cDNA" = blog_pal[["sky" ]]+ scale_x_continuous (limits = c (25 , 105 ), breaks = c (30 , 36 , 42 , 50 , 95 , 100 ), expand = c (0 , 0 )) + scale_y_continuous (expand = c (0 , 0 )) + labs (x = "position along the molecule (schematic)" , y = NULL , fill = NULL ) + theme (axis.text.y = element_blank ())
两个关键点:
条码必须唯一 :10x 的 3’ 试剂盒使用约 737,000 个已知条码(whitelist),随机序列长度 16 bp。条码不是完全不碰撞,但在给定细胞数下碰撞概率很低,而且可以通过“真实条码 vs 背景条码”的计数分布区分。UMI 必须足够多 :10x 3’ 使用 12 bp UMI(约 1,600 万种),实际测到的分子数远小于这个数量级,所以 UMI 碰撞可以忽略;但深度很高时需要校正(UMI saturation)。
3. 细胞的状态到底是什么
“细胞类型”和“细胞状态”经常被混用,但它们不是一回事。
类型(type) :相对稳定,由发育来源和核心调控网络决定,比如 T 细胞、B 细胞、髓系细胞、内皮细胞。状态(state) :在类型内部连续变化,可逆或半可逆,比如细胞周期、激活、耗竭、应激、代谢切换、分化中间态。
测序测到的其实只是一个转录组快照 :某个时刻、某个细胞里各个基因的 mRNA 分子数。状态则是从这个快照里推断出来的结构——哪些基因模块一起打开、细胞处在轨迹的哪一段、和参考图谱的哪一类最接近。
这也是为什么单细胞分析里“聚类”只是中间产物:聚类给的是离散的盒子,而细胞状态往往是连续的。后面的拟时序、RNA velocity、模块打分,都是为了把盒子重新拆成连续谱。
一个实用的判断标准是:如果你能用三五个 marker 稳定地区分两群细胞,它们更像类型;如果两群之间是渐变、而且可以被刺激/时间/剂量连续调节,它们更像状态。
4. 平台与方法
单细胞测序的核心难点不是测序本身,而是如何把每个 mRNA 分子归回它来自的那个细胞 。主流方案分成几类:
微流控液滴 :细胞和凝胶珠被油相包成一个个液滴,珠子上带着细胞条码(cell barcode)和分子标签(UMI)。10x Genomics Chromium、Drop-seq、inDrop 都属于这一类,通量高、单细胞成本低。纳米孔/微孔阵列 :Seq-Well、BD Rhapsody 把细胞沉降到微孔里,再放上带条码的珠子,不依赖液滴,细胞捕获更温和。板式分选 :Smart-seq2 / Smart-seq3 用 FACS 把单个细胞分到 96 或 384 孔板,全长转录本、灵敏度高,但通量低、成本高。组合索引 :SPLiT-seq、sci-RNA-seq 用多轮连接/拆分给细胞打“组合条码”,不需要专门仪器,适合超大规模。单细胞多组学 :10x Multiome 同时测 RNA 和 ATAC;CITE-seq 在 RNA 之外加抗体标签;Mission Bio Tapestri 做单细胞 DNA;单细胞甲基化有 scBS-seq、scNMT。空间转录组 :Visium、Xenium、CosMx、MERFISH 保留位置信息,是“单细胞”与“组织切片”的交叉。
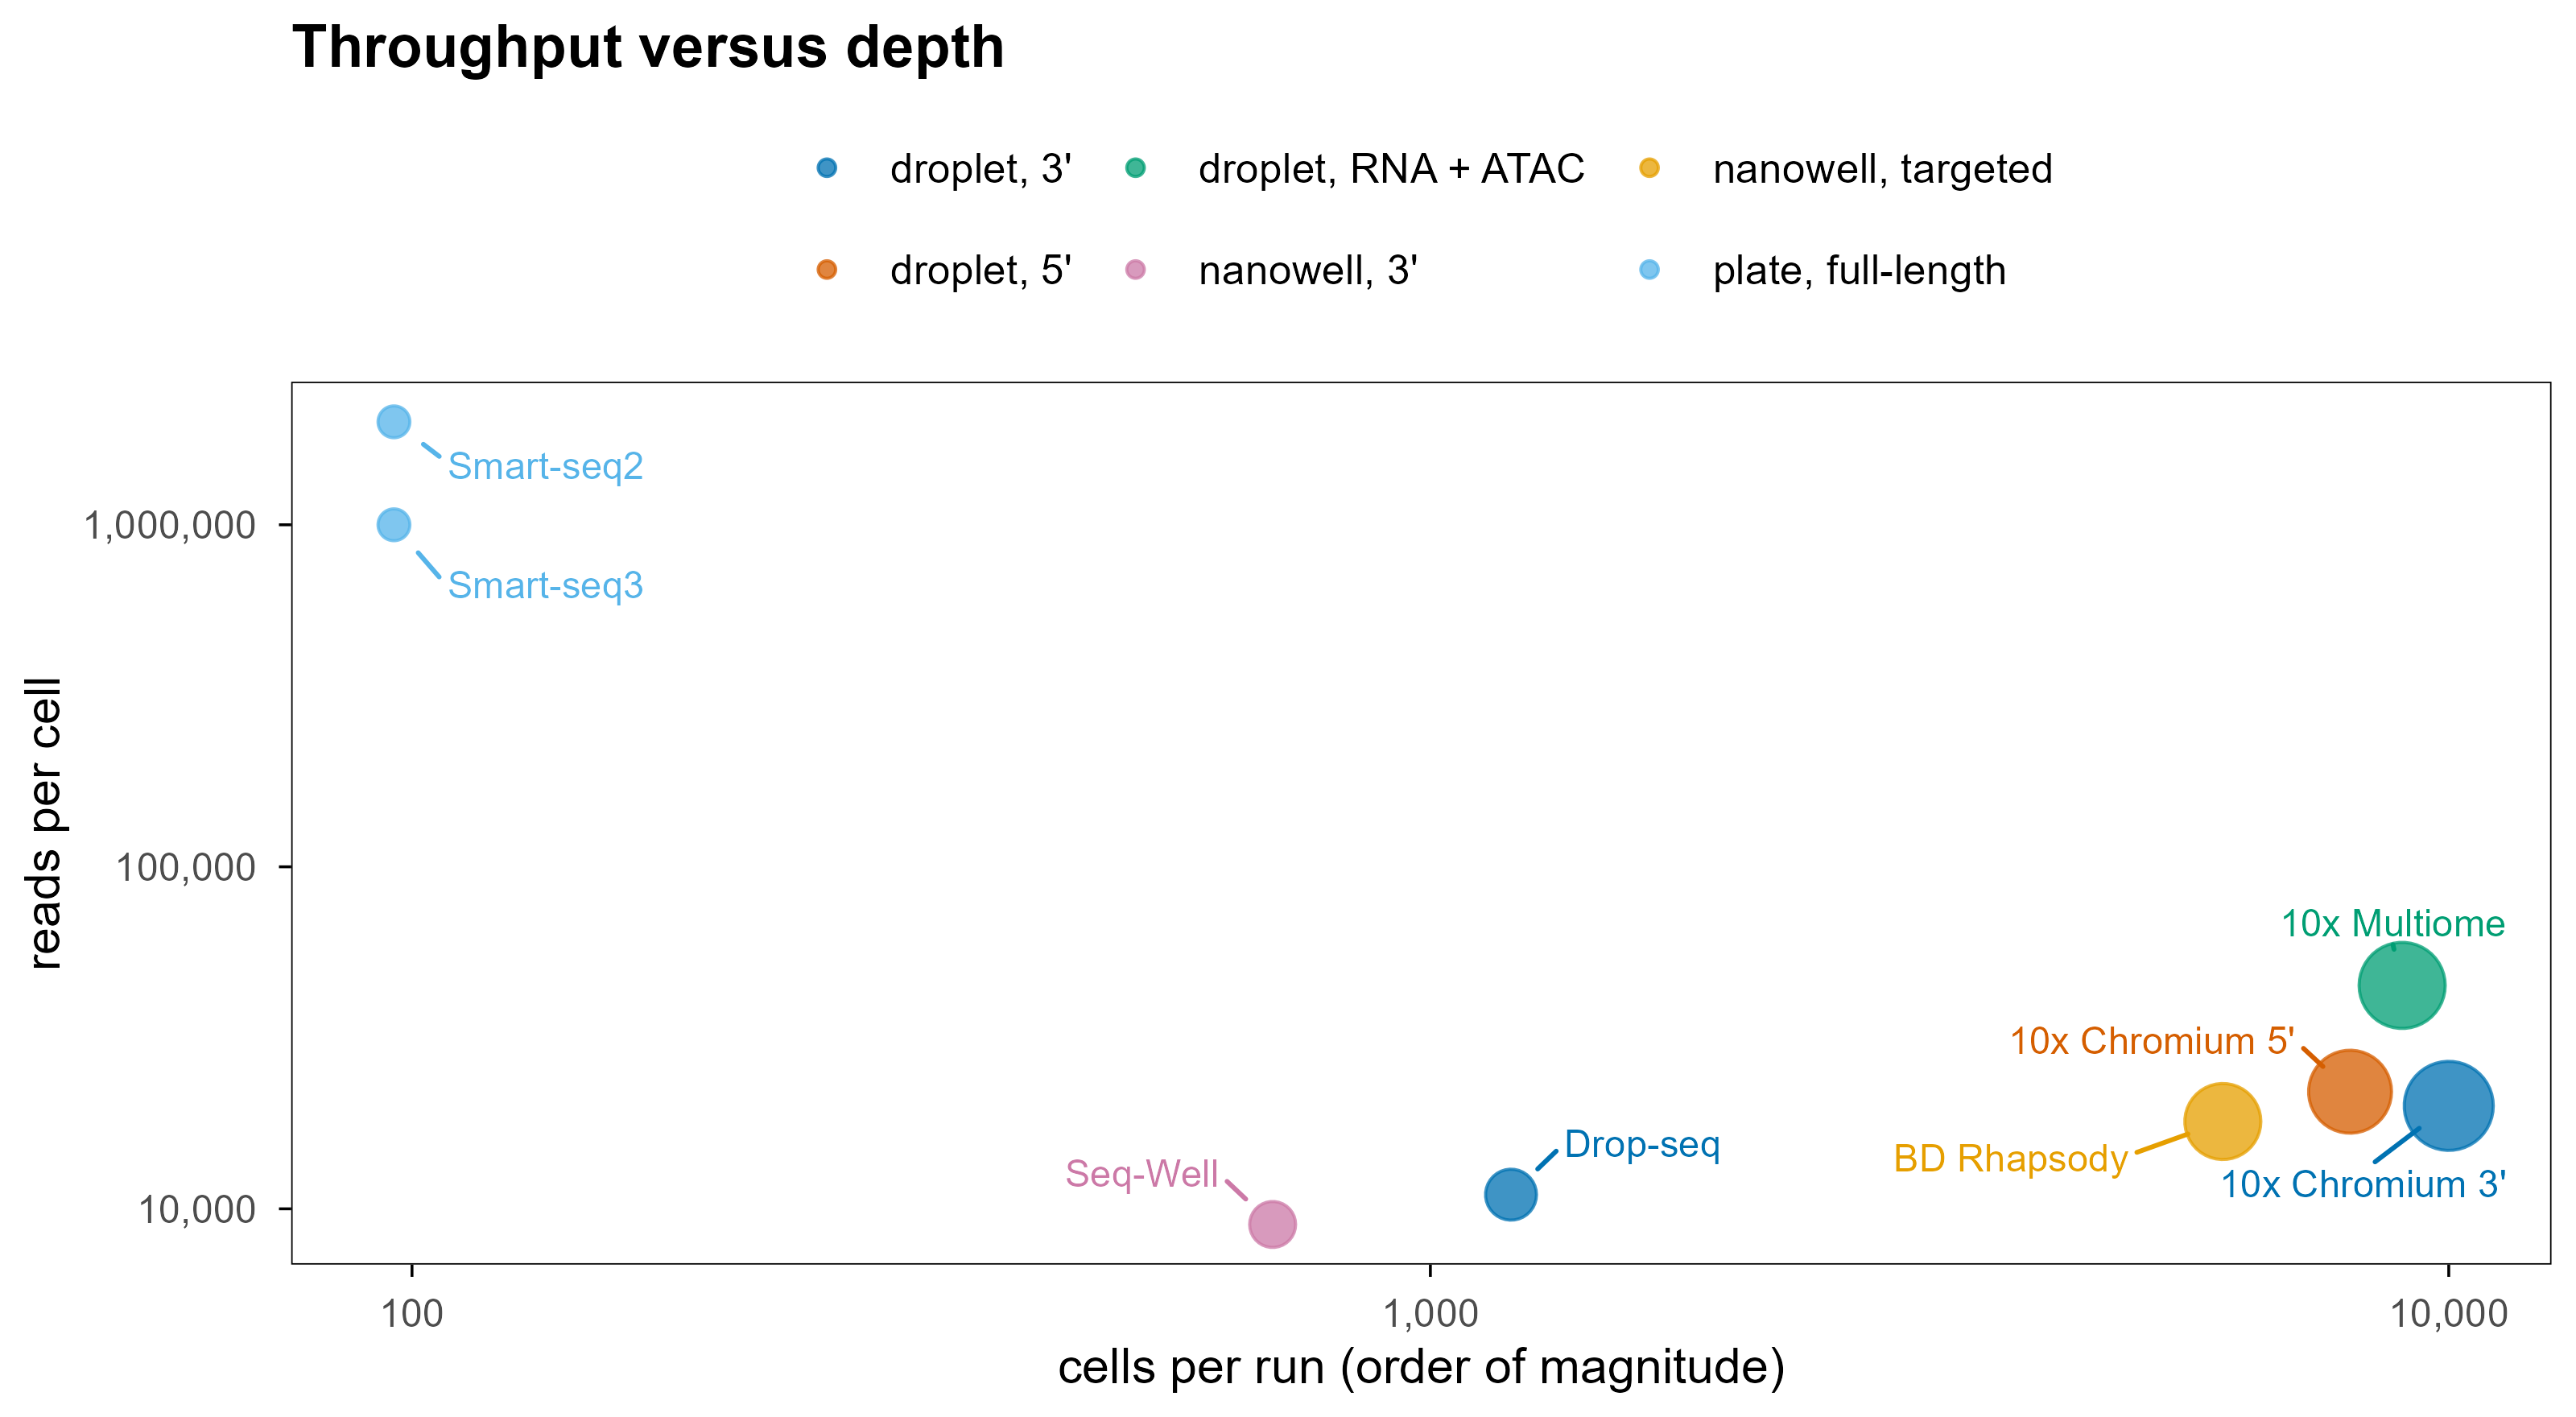
<- data.frame (platform = c ("10x Chromium 3'" , "10x Chromium 5'" , "10x Multiome" ,"Smart-seq2" , "Smart-seq3" , "Drop-seq" , "Seq-Well" , "BD Rhapsody" cells = c (1.0e4 , 8.0e3 , 9.0e3 , 96 , 96 , 1.2e3 , 7.0e2 , 6.0e3 ),reads = c (2.0e4 , 2.2e4 , 4.5e4 , 2.0e6 , 1.0e6 , 1.1e4 , 9.0e3 , 1.8e4 ),mode = c ("droplet, 3'" , "droplet, 5'" , "droplet, RNA + ATAC" ,"plate, full-length" , "plate, full-length" ,"droplet, 3'" , "nanowell, 3'" , "nanowell, targeted" ggplot (platforms, aes (cells, reads, colour = mode)) + geom_point (aes (size = cells), alpha = 0.75 ) + :: geom_text_repel (aes (label = platform), size = 3 , show.legend = FALSE ,min.segment.length = 0 , point.padding = 0.5 , box.padding = 0.7 ,max.overlaps = Inf , seed = 1 + scale_x_log10 (labels = label_comma ()) + scale_y_log10 (labels = label_comma ()) + scale_size_continuous (range = c (3 , 9 ), guide = "none" ) + scale_colour_manual (values = c (pal[1 : 3 ], pal[4 : 7 ])) + labs (x = "cells per run (order of magnitude)" , y = "reads per cell" ,colour = NULL , title = "Throughput versus depth"
10x Chromium 3’
液滴
3’ 端
有
常规 scRNA-seq、细胞图谱
10x Chromium 5’
液滴
5’ 端
有
V(D)J、TCR/BCR 克隆型
10x Multiome
液滴
RNA + ATAC
有
调控元件与表达联合
Smart-seq2
FACS 孔板
全长
无(用 Tn5 或分子标签)
低通量、高灵敏、可变剪接
Smart-seq3
FACS 孔板
全长 + 5’ UMI
部分
等位基因表达、剪接
Drop-seq
液滴
3’ 端
有
低成本、方法学
Seq-Well
微孔
3’ 端
有
低输入、临床样本
BD Rhapsody
微孔
靶向/全转录组
有
靶向 panel、蛋白联合
CITE-seq
液滴 + 抗体
RNA + 表面蛋白
有
免疫分型
Visium / Xenium
空间
3’ 端 / 靶向
有
组织原位状态
选平台时真正要权衡的是四个量:细胞数、每个细胞的深度、每个细胞的价格、以及是否要全长/多组学/空间信息 。10x 3’ 适合“细胞多、问题偏组成和类型”;Smart-seq 适合“细胞少、问题偏异构体、融合基因、低丰度转录本”。
5. 实验设计:在测序之前就决定了数据质量
很多单细胞数据的问题不是分析造成的,而是实验设计造成的。
细胞数 :常规图谱 5,000–20,000 个细胞足够;要做稀有细胞或连续状态,需要更多。上样细胞数 ≠ 回收细胞数,10x 的回收率通常 50%–70%。测序深度 :每个细胞 20,000–50,000 reads 是常见区间。深度不足表现为基因数少、dropout 多;深度过高则边际收益很低(见后面的饱和曲线)。生物学重复 :单细胞不能替代重复。每个条件至少 2–3 个供体/样本,否则无法区分处理效应和个体差异。批次 :不同天、不同操作者、不同 10x 芯片都是批次。设计上应尽量让每个批次包含所有条件(balanced design),而不是“一天做对照、一天做处理”。** Multiplexing**:用 hashing 抗体(CellPlex)或基因型把多个样本混进一个 10x lane,可以显著降低批次效应,但需要额外的去卷积步骤。
组织解离 :酶解会诱导应激基因(FOS、JUN、HSPA1A 等),可能需要加入转录抑制剂或改用单核测序(snRNA-seq)。样本质量 :冻存、存活率、RNA 完整性(RIN)都会直接影响空液滴比例和线粒体比例。
6. 细胞组成:第一个能讲故事的图
拿到聚类之后,最直观的问题是“细胞类型比例有没有变化”。这也是单细胞项目里最容易被过度解读的图之一:比例受捕获效率、解离偏好、测序深度影响,必须结合重复和统计检验。
<- data.frame (sample = rep (c ("Ctrl-1" , "Ctrl-2" , "Treat-1" , "Treat-2" ), each = 5 ),celltype = rep (c ("T" , "B" , "Myeloid" , "NK" , "Stromal" ), 4 ),pct = c (0.32 , 0.24 , 0.28 , 0.10 , 0.06 ,0.30 , 0.26 , 0.27 , 0.11 , 0.06 ,0.48 , 0.12 , 0.25 , 0.10 , 0.05 ,0.46 , 0.14 , 0.26 , 0.09 , 0.05 ggplot (comp, aes (sample, pct, fill = celltype)) + geom_col (width = 0.65 ) + scale_fill_manual (values = pal[1 : 5 ]) + scale_y_continuous (labels = percent_format ()) + labs (x = NULL , y = "fraction of cells" , fill = NULL )
7. 原始数据与文件格式
这是最容易含糊过去、但实际最影响后续分析的一节。单细胞项目从下机到分析,会经过至少六种文件格式。
7.1 BCL:测序仪的原始输出
测序仪下机的不是序列,而是每个 cycle、每个 tile 的荧光强度 ,存在 BCL 文件里。一个 run 的目录大致长这样:
200101_A00123_0001_AH7VLYDSX2/
├── RunInfo.xml                  # 读长、cycle 数、tile 布局
├── SampleSheet.csv              # 样本索引与 lane 对应关系
├── Data/
│   └── Intensities/
│       └── BaseCalls/
│           ├── L001/
│           │   ├── C1.1/s_1_1101.bcl
│           │   └── C1.1/s_1_1101.stats
│           └── L002/...
└── InterOp/ # 质控指标bcl2fastq(Illumina)或 bcl-convert 负责 base calling 和 demultiplex,把 BCL 变成 FASTQ。对 10x 而言,一个 lane 里所有细胞的 reads 混在一起,靠 Read 1 的条码区分细胞。
7.2 FASTQ:序列 + 质量值
FASTQ 是四行一条记录:header、序列、+、质量值(Phred33)。10x 的 Read 1 和 Read 2 是分开的两个文件:
@A00123:8:H7VLYDSX2:1:1101:1000:1000 1:N:0:SI-GA-A1
CAGGTGATTCAGACGTGTGCTCTTCCGATCT
+
FFFFF,FFFFFFFFFFFFFFFFFFFFF
@A00123:8:H7VLYDSX2:1:1101:1000:1000 2:N:0:SI-GA-A1
GATTACAGATTACAGGCGTGAGCCACCACGC
+
FFFFFFFFFFFFFFFFFFFFFFFFFFFFF
Header 里的 1:N:0:SI-GA-A1 表示 read 1、未过滤、样本索引。
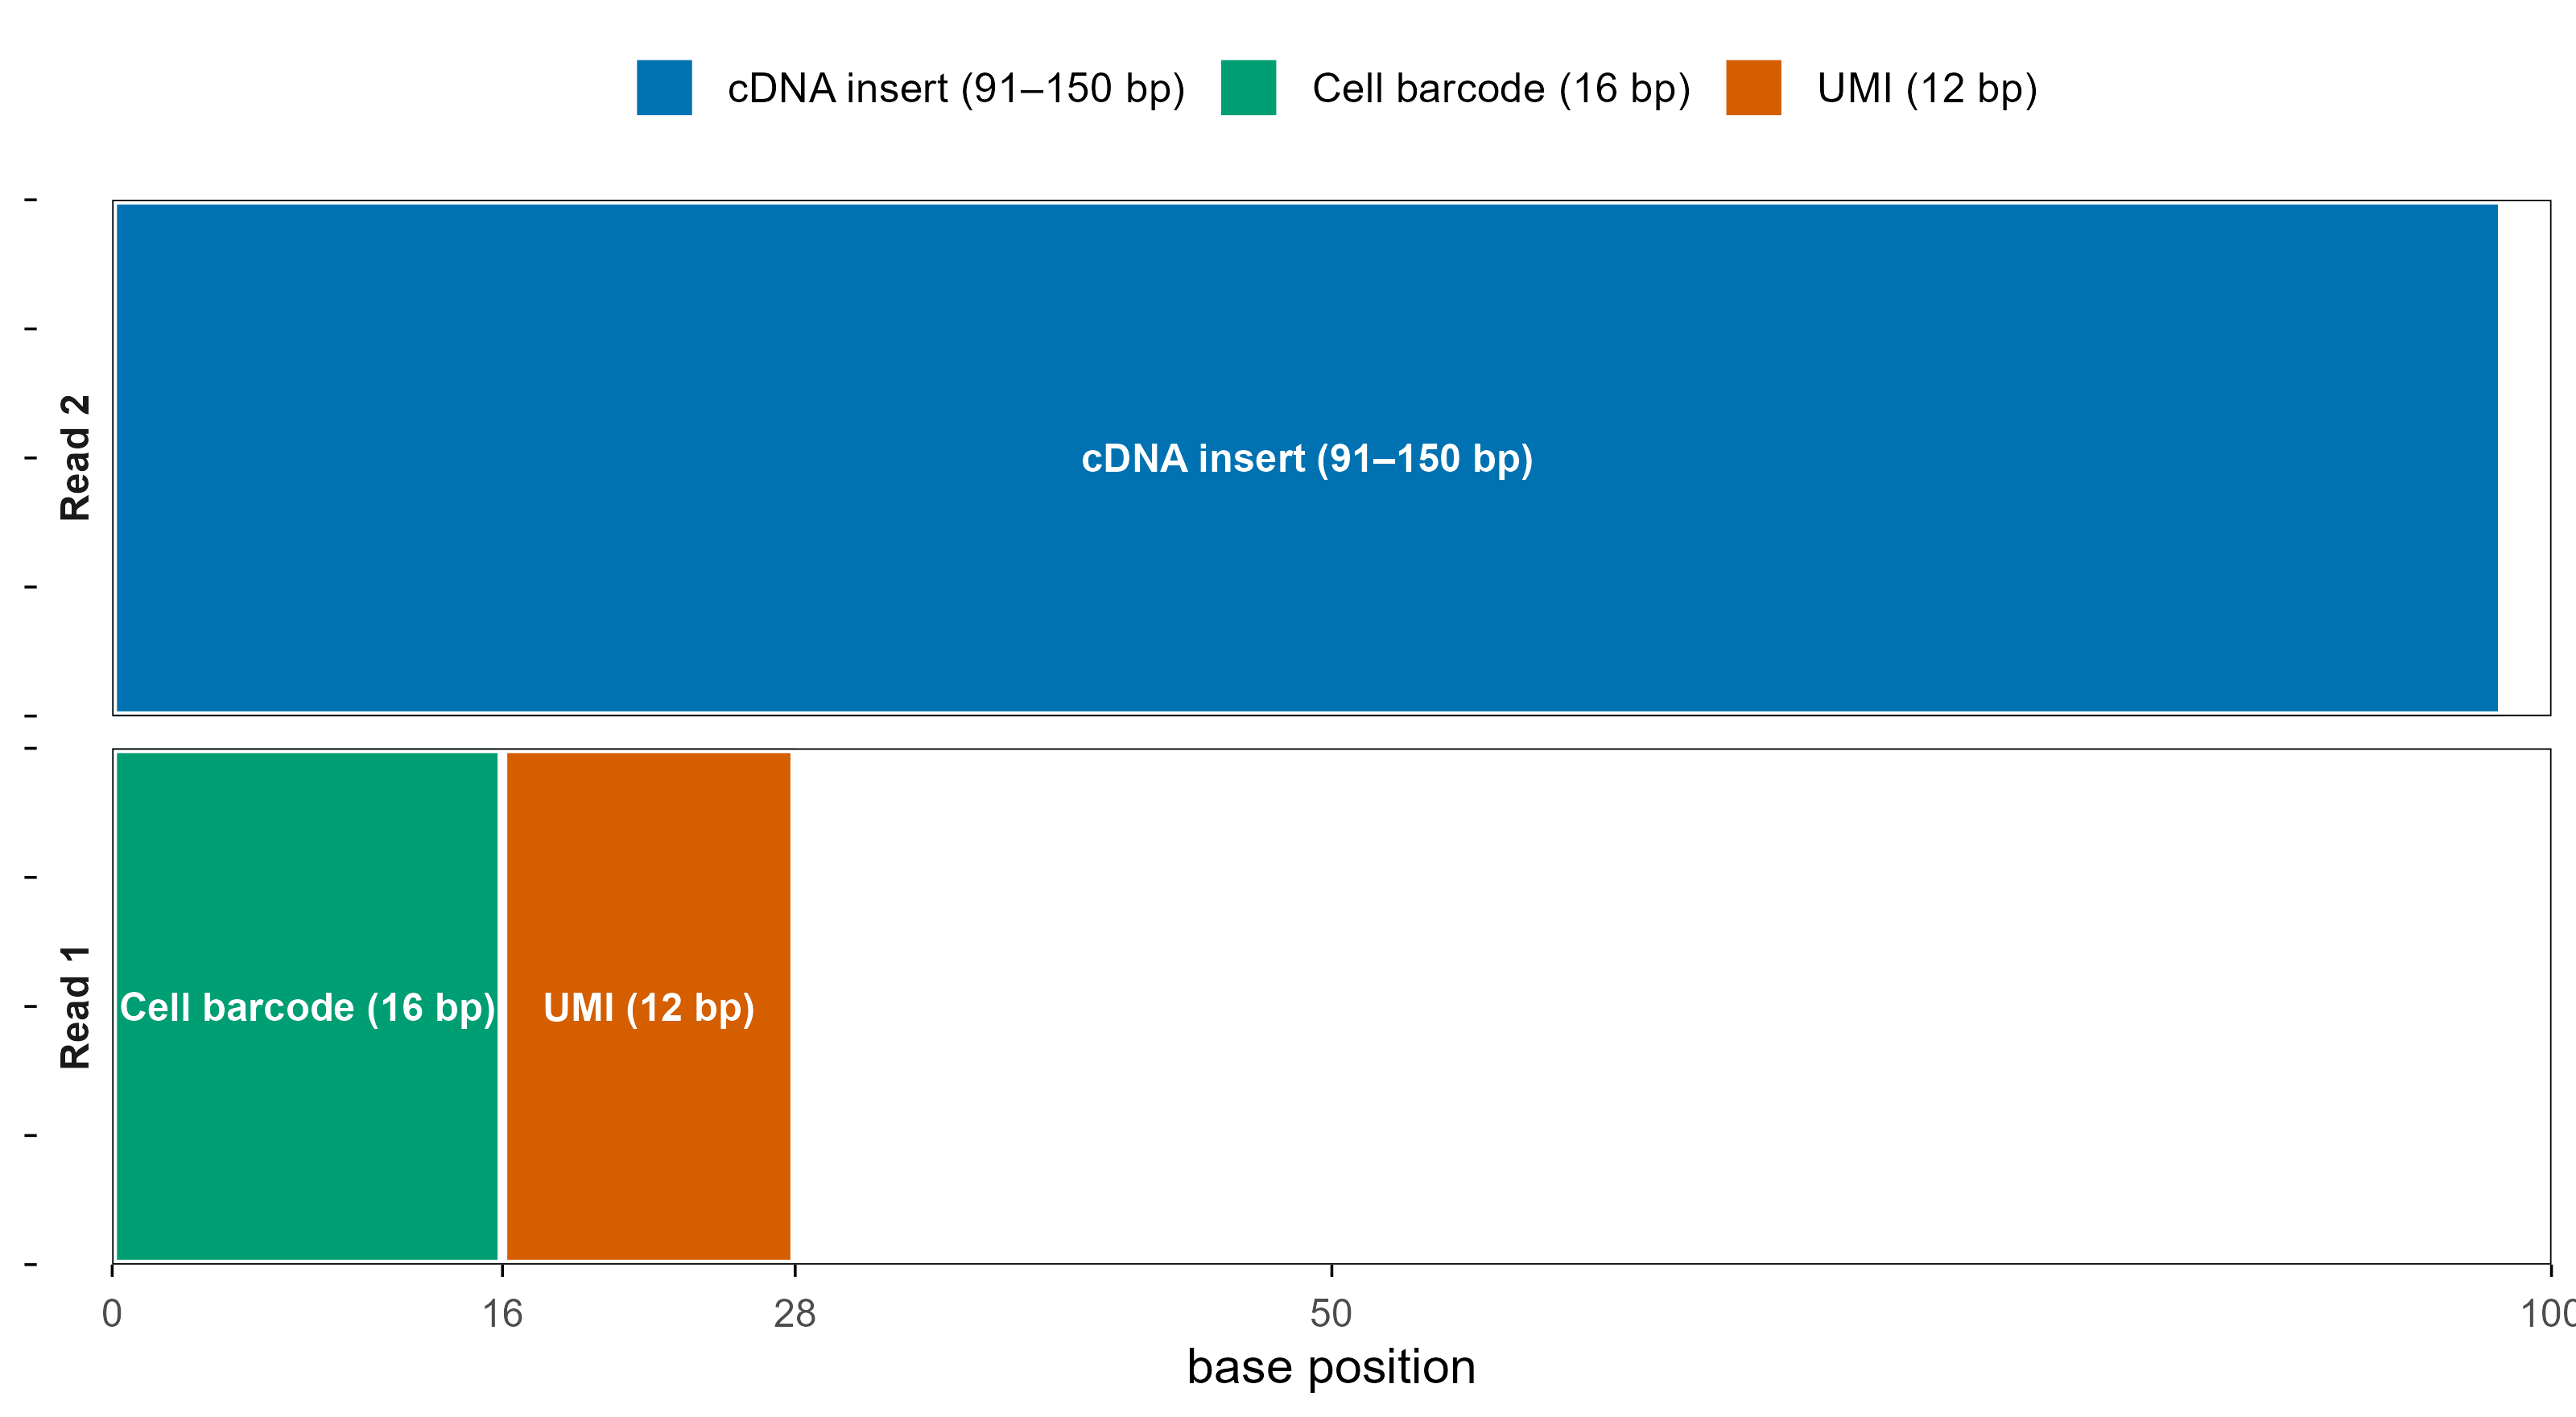
Read 1 的前 16 bp 是细胞条码,后 12 bp 是 UMI。
Read 2 是 cDNA 插入片段。这时候还没有“基因”这个概念 ,只有碱基和位置。
<- data.frame (read = factor (c ("Read 1" , "Read 1" , "Read 2" ),levels = c ("Read 2" , "Read 1" )start = c (0 , 16 , 0 ),end = c (16 , 28 , 98 ),feature = c ("Cell barcode (16 bp)" , "UMI (12 bp)" , "cDNA insert (91–150 bp)" )ggplot (read_map, aes (xmin = start, xmax = end, ymin = 0 , ymax = 1 , fill = feature)) + geom_rect (colour = "white" , linewidth = 1 ) + geom_text (aes (x = (start + end) / 2 , y = 0.5 , label = feature),colour = "white" , fontface = "bold" , size = 3.1 + facet_wrap (~ read, ncol = 1 , strip.position = "left" ) + scale_fill_manual (values = c (blog_pal[["blue" ]], blog_pal[["green" ]], blog_pal[["vermillion" ]])) + scale_x_continuous (breaks = c (0 , 16 , 28 , 50 , 100 ), limits = c (0 , 100 ), expand = c (0 , 0 )) + scale_y_continuous (expand = c (0 , 0 )) + labs (x = "base position" , y = NULL , fill = NULL ) + theme (axis.text.y = element_blank (),strip.text.y = element_text (angle = 0 , face = "bold" )
7.3 BAM:比对后的 reads
比对(STAR / STARsolo / Cell Ranger)之后得到 BAM。单细胞 BAM 和普通 BAM 的区别在于每条 read 上多了两个标签:
CB:Z:AAACCTGAGAAACCAT-1 — 校正后的细胞条码。UB:Z:ACGTACGTACGT — 校正后的 UMI。
Cell Ranger 还会输出 possorted_genome_bam.bam(按坐标排序)和 molecule_info.h5(分子级别的信息,包含每个 UMI 的 reads 数、基因、条码)。如果要跑 RNA velocity、可变剪接或自定义计数,通常从 BAM 重新开始,而不是从 count matrix 开始。
7.4 计数矩阵:matrix.mtx + 两个 TSV
Cell Ranger 的标准输出是 Market Matrix(MTX) 三件套:
outs/filtered_feature_bc_matrix/
├── barcodes.tsv.gz    # 每一列是一个细胞条码
├── features.tsv.gz    # 每一行是一个基因(ensembl id + symbol + 类型)
└── matrix.mtx.gz      # 稀疏矩阵:行号 列号 值
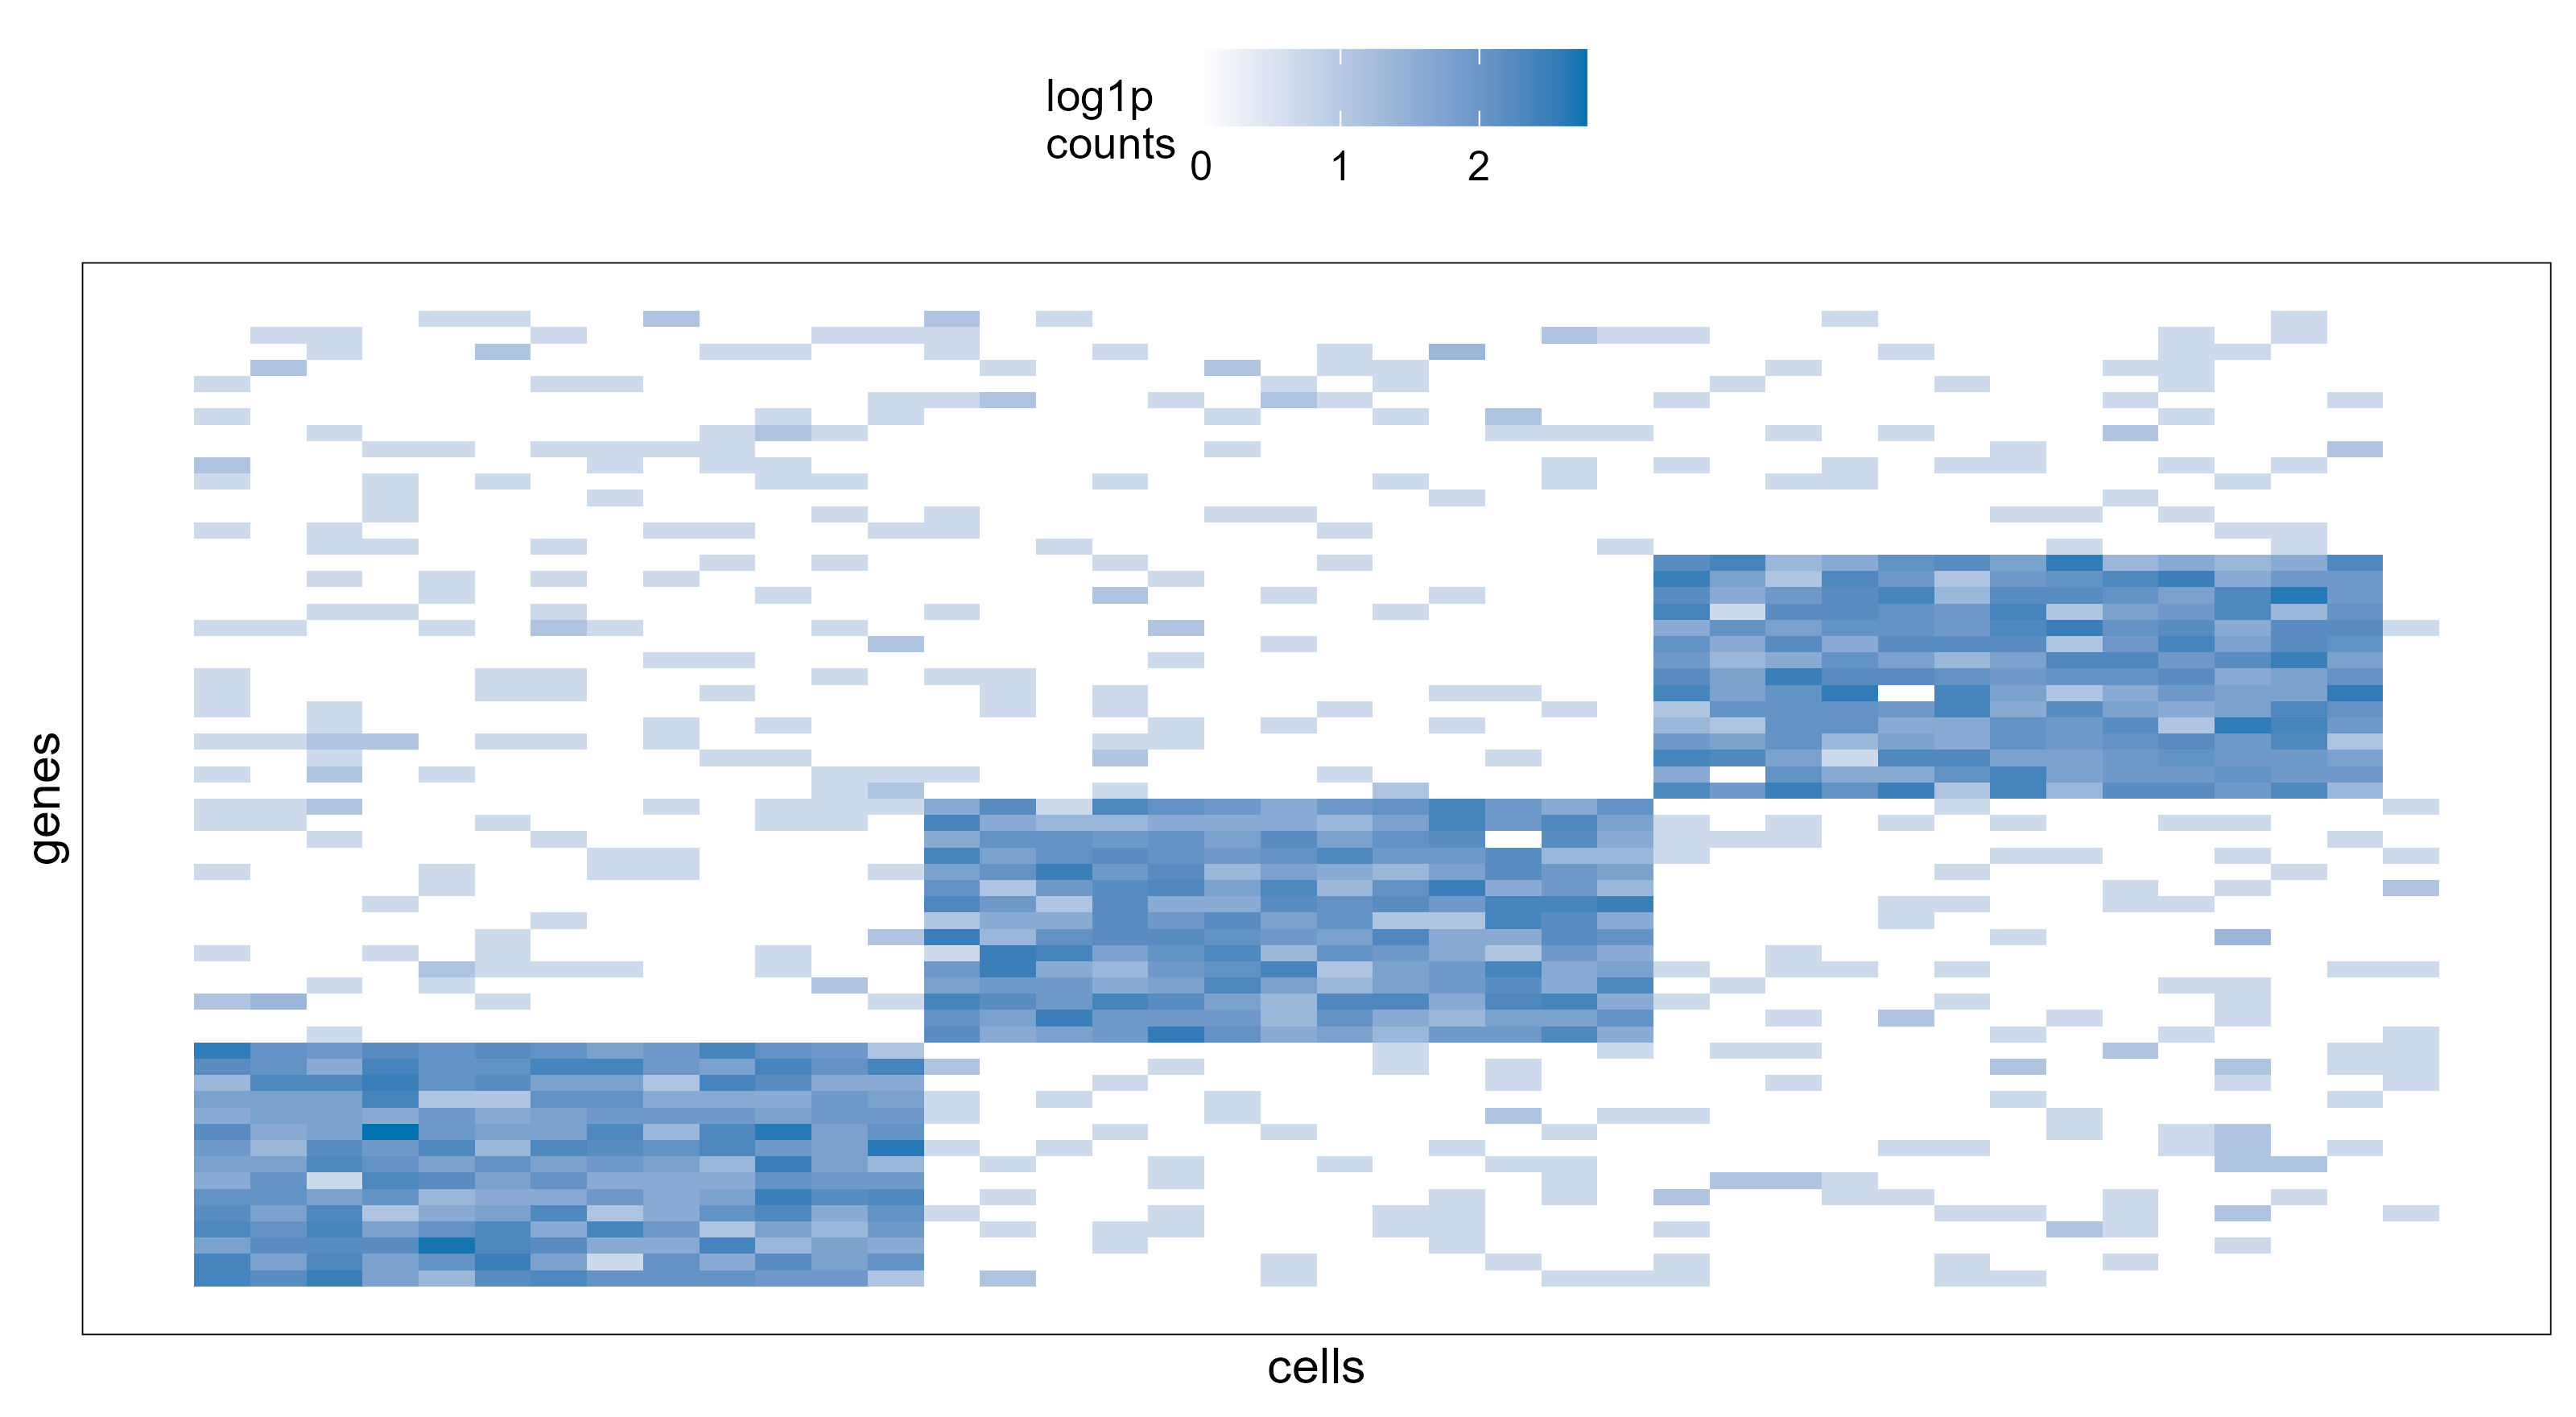
matrix.mtx 只存非零元素,文件头是矩阵维度,之后每行是 基因行号 细胞列号 UMI计数。这也是为什么单细胞矩阵必须用稀疏矩阵结构存储:90% 以上是 0。
set.seed (9 )<- 40 <- 60 <- matrix (rpois (n_cells * n_g, 0.25 ), nrow = n_g)for (i in 1 : 3 ) {<- ((i - 1 ) * 15 + 1 ): (i * 15 )<- ((i - 1 ) * 13 + 1 ): (i * 13 )<- counts[rows, cols] + rpois (length (rows) * length (cols), 6 )<- data.frame (gene = rep (1 : n_g, times = n_cells),cell = rep (1 : n_cells, each = n_g),count = as.vector (counts)ggplot (mat_df, aes (cell, gene, fill = log1p (count))) + geom_tile () + scale_fill_gradient (low = "#FFFFFF" , high = blog_pal[["blue" ]]) + labs (x = "cells" , y = "genes" , fill = "log1p \n counts" ) + theme (axis.text = element_blank (), axis.ticks = element_blank ())
这个 60 × 40 的小矩阵里有 59% 是 0。真实数据的非零比例通常只有 5%–15%。
7.5 HDF5 家族:.h5、.h5ad、.loom、.rds
除了 MTX,实际项目里更常见的是各种容器格式。它们本质上是矩阵 + 行/列注释 + 降维结果 的不同打包方式。
.h5Cell Ranger
稀疏矩阵 + 基因/细胞名 + 元数据
h5py、Seurat::Read10X_h5
.h5adScanpy / AnnData
X、obs、var、obsm、layers、unsscanpy.read_h5ad
.loomloompy
矩阵 + row_attr / col_attr
scanpy.read_loom、Seurat::ReadLoom
.rdsSeurat / R
完整 R 对象(含聚类、降维、图)
readRDS
.arrow / SOMATileDB-SOMA
列式存储,适合百万级细胞
tiledbsoma
.zarrAnnData / xarray
分块数组,适合云端
anndata.read_zarr
fragments.tsv.gz10x ATAC
每个 fragment 的 chrom/start/end/barcode
ArchR、Signac
.tif + positions.csvVisium / Xenium
组织图像 + 斑点/细胞坐标
Space Ranger、Seurat
.h5ad 的内部结构值得单独记住,因为几乎所有 Python 单细胞工具都以它为中心:
AnnData
├── X          cells × genes 的表达矩阵(通常是稀疏 CSR)
├── obs        每个细胞的元数据:barcode、QC、cluster、sample
├── var        每个基因的元数据:gene id、HVG、mean、dispersion
├── obsm       降维结果:X_pca、X_umap、X_scvi
├── obsp       细胞间图:connectivities、distances
├── layers     同一批细胞的其它矩阵:counts、normalized、scaled
├── raw        原始表达(标准化前)
└── uns        非结构化信息:颜色、参数、邻居数
对应的读取代码:
import scanpy as sc# 10x MTX 目录 = sc.read_10x_mtx("outs/filtered_feature_bc_matrix" , var_names= "gene_symbols" )# h5ad = sc.read_h5ad("adata.h5ad" )# loom = sc.read_loom("adata.loom" )library (Seurat)# 10x MTX 目录 <- Read10X ("outs/filtered_feature_bc_matrix" )<- CreateSeuratObject (counts)# Cell Ranger 的 h5 <- Read10X_h5 ("outs/filtered_feature_bc_matrix.h5" )# 保存好的 Seurat 对象 <- readRDS ("seurat.rds" )
实践建议 :分析中间结果尽量用 .h5ad 或 .rds 保存完整对象,而不是只保存矩阵。只存矩阵会丢掉聚类、降维、参数和元数据,下一次分析无法复现。
7.6 Cell Ranger 输出目录
一个典型的 outs/ 目录包含:
outs/
├── filtered_feature_bc_matrix/     # 过滤后的细胞 × 基因矩阵(分析起点)
├── raw_feature_bc_matrix/          # 全部条码(含空液滴,用于 EmptyDrops)
├── molecule_info.h5                # 分子级信息(UMI、reads、基因)
├── possorted_genome_bam.bam        # 比对结果(含 CB/UB 标签)
├── possorted_genome_bam.bam.bai
├── metrics_summary.csv             # 关键 QC 指标
├── web_summary.html                # 自动报告(knee plot、饱和度、比对率)
└── cloupe.cloupe                   # Loupe Browser 可视化文件
8. 从 FASTQ 到 count matrix
以 10x 官方流程(Cell Ranger / STARsolo)为例,中间要做五件事:条码校正、比对、基因分配、UMI 去重、细胞 calling。
8.1 条码校正
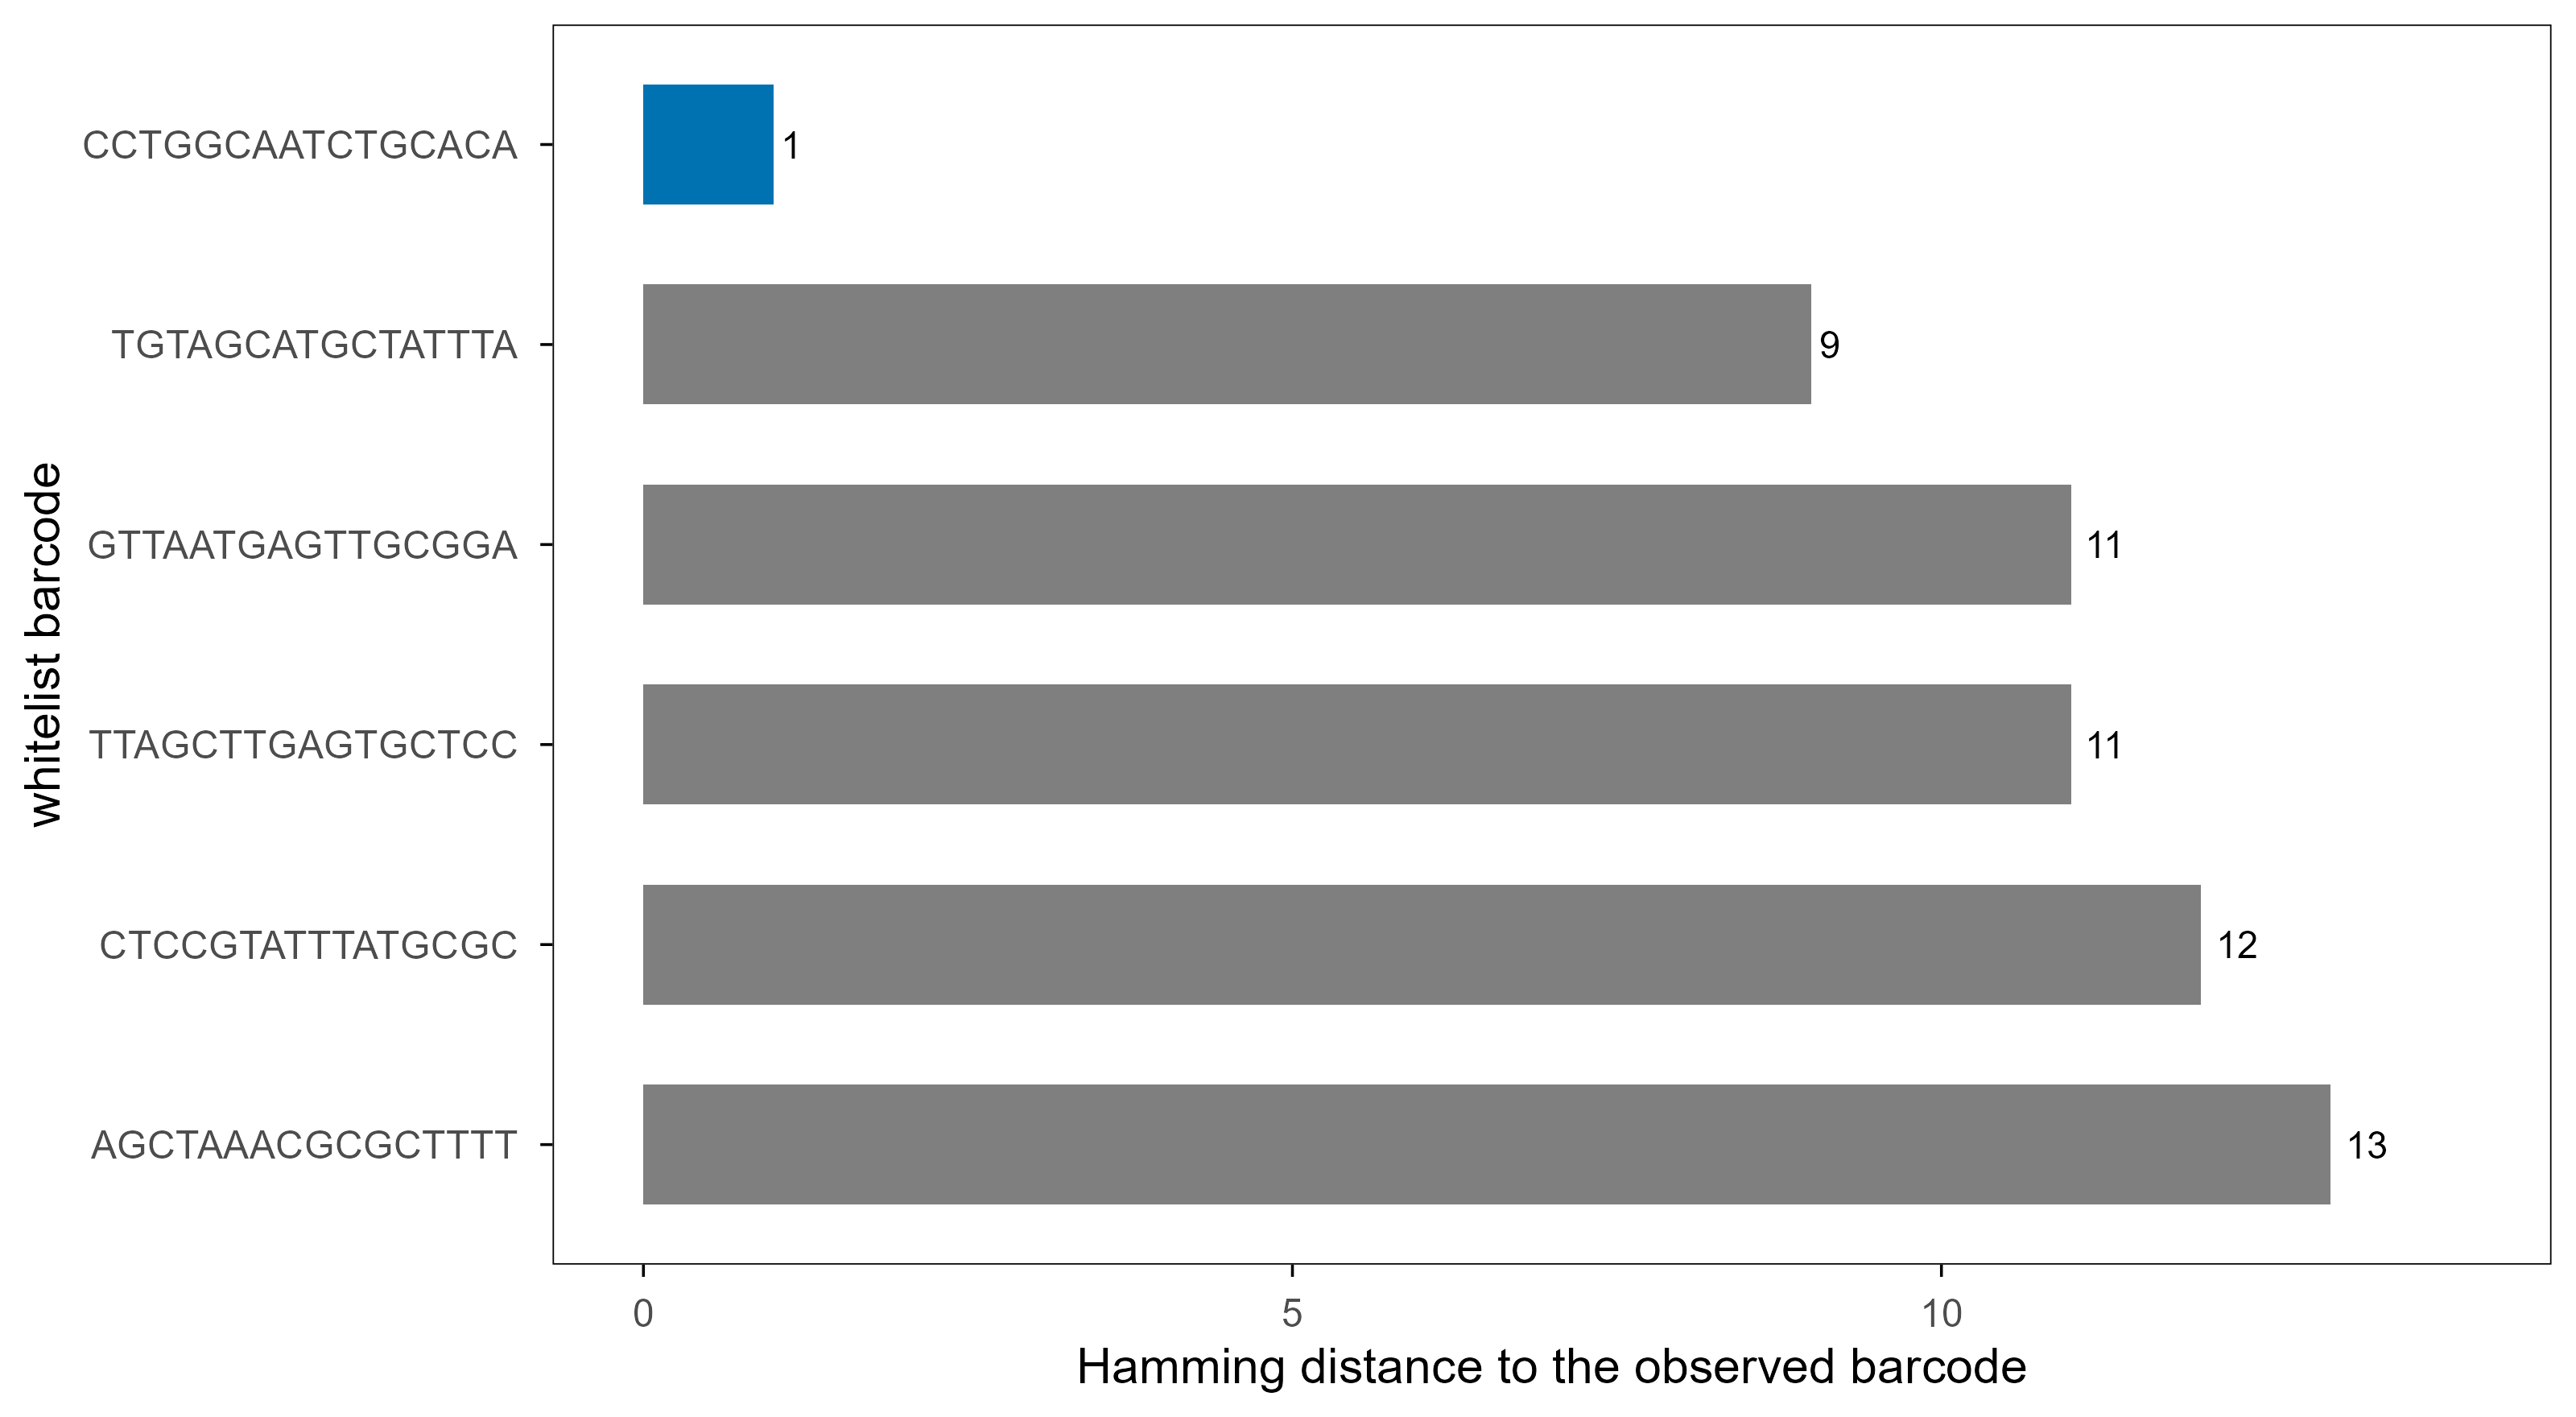
测序错误会让读到的 16 bp 条码与白名单不完全一致。标准做法是:如果某个条码与白名单中的某个条码只差 1 个碱基(Hamming distance = 1) ,就把它校正为白名单条码;差 2 个及以上则归入“未识别”。这一步必须在 UMI 去重之前完成,否则同一个细胞的 reads 会被拆成多个“假细胞”。
set.seed (12 )<- function () paste (sample (c ("A" , "C" , "G" , "T" ), 16 , replace = TRUE ), collapse = "" )<- replicate (6 , make_bc ())<- whitelist[1 ]substr (observed, 8 , 8 ) <- ifelse (substr (observed, 8 , 8 ) == "A" , "C" , "A" )<- function (a, b) sum (strsplit (a, "" )[[1 ]] != strsplit (b, "" )[[1 ]])<- data.frame (candidate = whitelist,distance = vapply (whitelist, function (b) hamming (observed, b), numeric (1 ))<- bc[order (bc$ distance), ]$ candidate <- factor (bc$ candidate, levels = rev (bc$ candidate))ggplot (bc, aes (distance, candidate, fill = distance == min (distance))) + geom_col (width = 0.6 ) + geom_text (aes (label = distance), hjust = - 0.35 , size = 3 ) + scale_fill_manual (values = c (` FALSE ` = blog_pal[["grey" ]], ` TRUE ` = blog_pal[["blue" ]]),guide = "none" + scale_x_continuous (limits = c (0 , max (bc$ distance) + 1 )) + labs (x = "Hamming distance to the observed barcode" , y = "whitelist barcode" )
工程上还有两个细节:
条码白名单随试剂盒版本变化 ,用错版本会导致大量条码无法识别;Cell Ranger 会根据试剂盒自动选择。条码不是绝对唯一 :约 737k 个条码里,两个真实细胞共用同一个条码的概率很低,但百万级细胞的项目需要评估碰撞。
8.2 比对与基因分配
Read 2 比对到参考基因组/转录组,得到它来自哪个基因的哪个位置。几个影响结果的参数:
参考版本 :GRCh38 的不同 patch、GENCODE 版本会改变基因集合和计数。外显子 vs 全基因 :STARsolo 的 Gene 只数外显子,GeneFull 把内含子也算进去。后者对单核 RNA-seq(snRNA-seq)很重要,因为细胞核里大量是未剪接转录本。链方向 :10x 3’ 文库是反向链(reverse stranded),参数错了会得到几乎为 0 的计数。多比对 reads :重复序列、假基因、rRNA 会造成 multi-mapping。STARsolo 用 EM 算法在候选基因之间分配,而不是简单丢弃。rRNA/线粒体 :通常单独统计,不进入下游 HVG。
8.3 UMI 去重
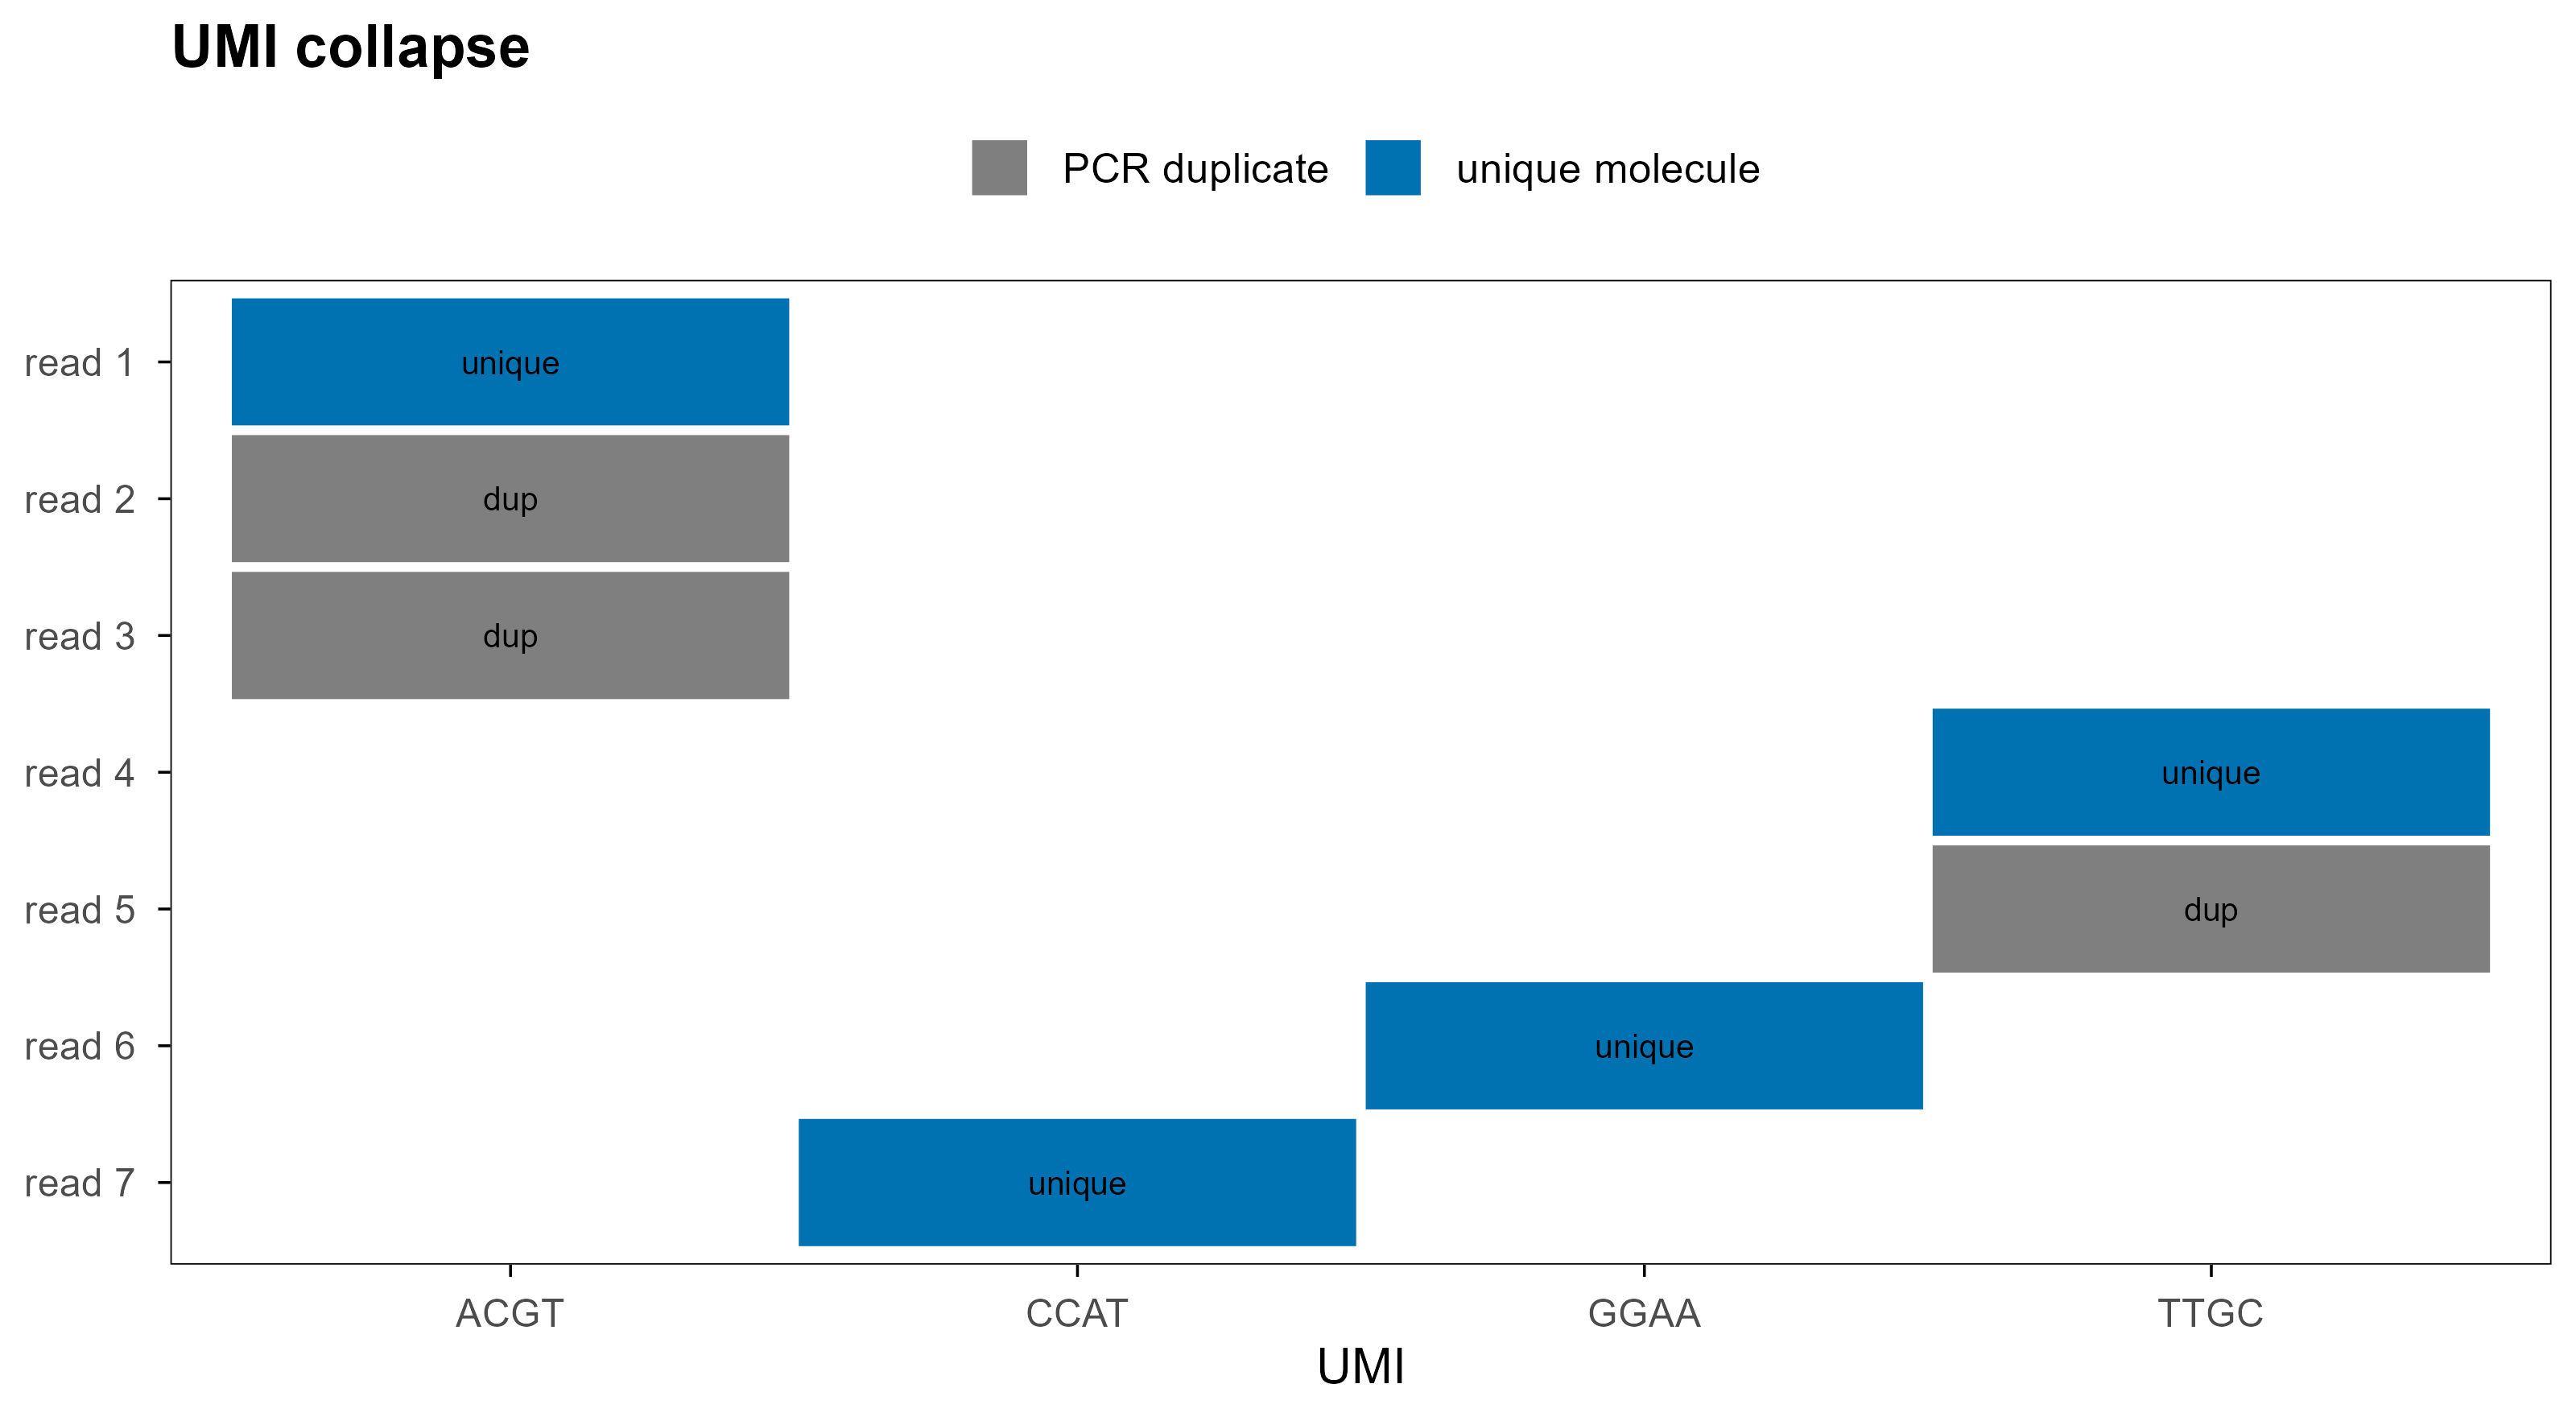
同一个细胞里,同一个 UMI + 同一个基因的多条 read,视为同一个原始 mRNA 分子的 PCR 拷贝,只计一次。
<- data.frame (read = factor (paste0 ("read " , 1 : 7 ), levels = rev (paste0 ("read " , 1 : 7 ))),umi = c ("ACGT" , "ACGT" , "ACGT" , "TTGC" , "TTGC" , "GGAA" , "CCAT" ),gene = c ("CD3D" , "CD3D" , "CD3D" , "CD3D" , "CD3D" , "LYZ" , "LYZ" )$ status <- ifelse (duplicated (umi[, c ("umi" , "gene" )]), "PCR duplicate" , "unique molecule" )ggplot (umi, aes (umi, read, fill = status)) + geom_tile (colour = "white" , linewidth = 1 ) + geom_text (aes (label = ifelse (status == "PCR duplicate" , "dup" , "unique" )),size = 2.6 + scale_fill_manual (values = c ("unique molecule" = blog_pal[["blue" ]],"PCR duplicate" = blog_pal[["grey" ]]+ labs (x = "UMI" , y = NULL , fill = NULL , title = "UMI collapse" )
严格去重(exact matching)会把测序错误的 UMI 当成新分子;更常用的策略是方向性邻接去重 (directional adjacency):只有当一个 UMI 的 reads 数远少于邻居、且只差 1 个碱基时,才把它合并。UMI-tools、Cell Ranger 都实现了类似逻辑。
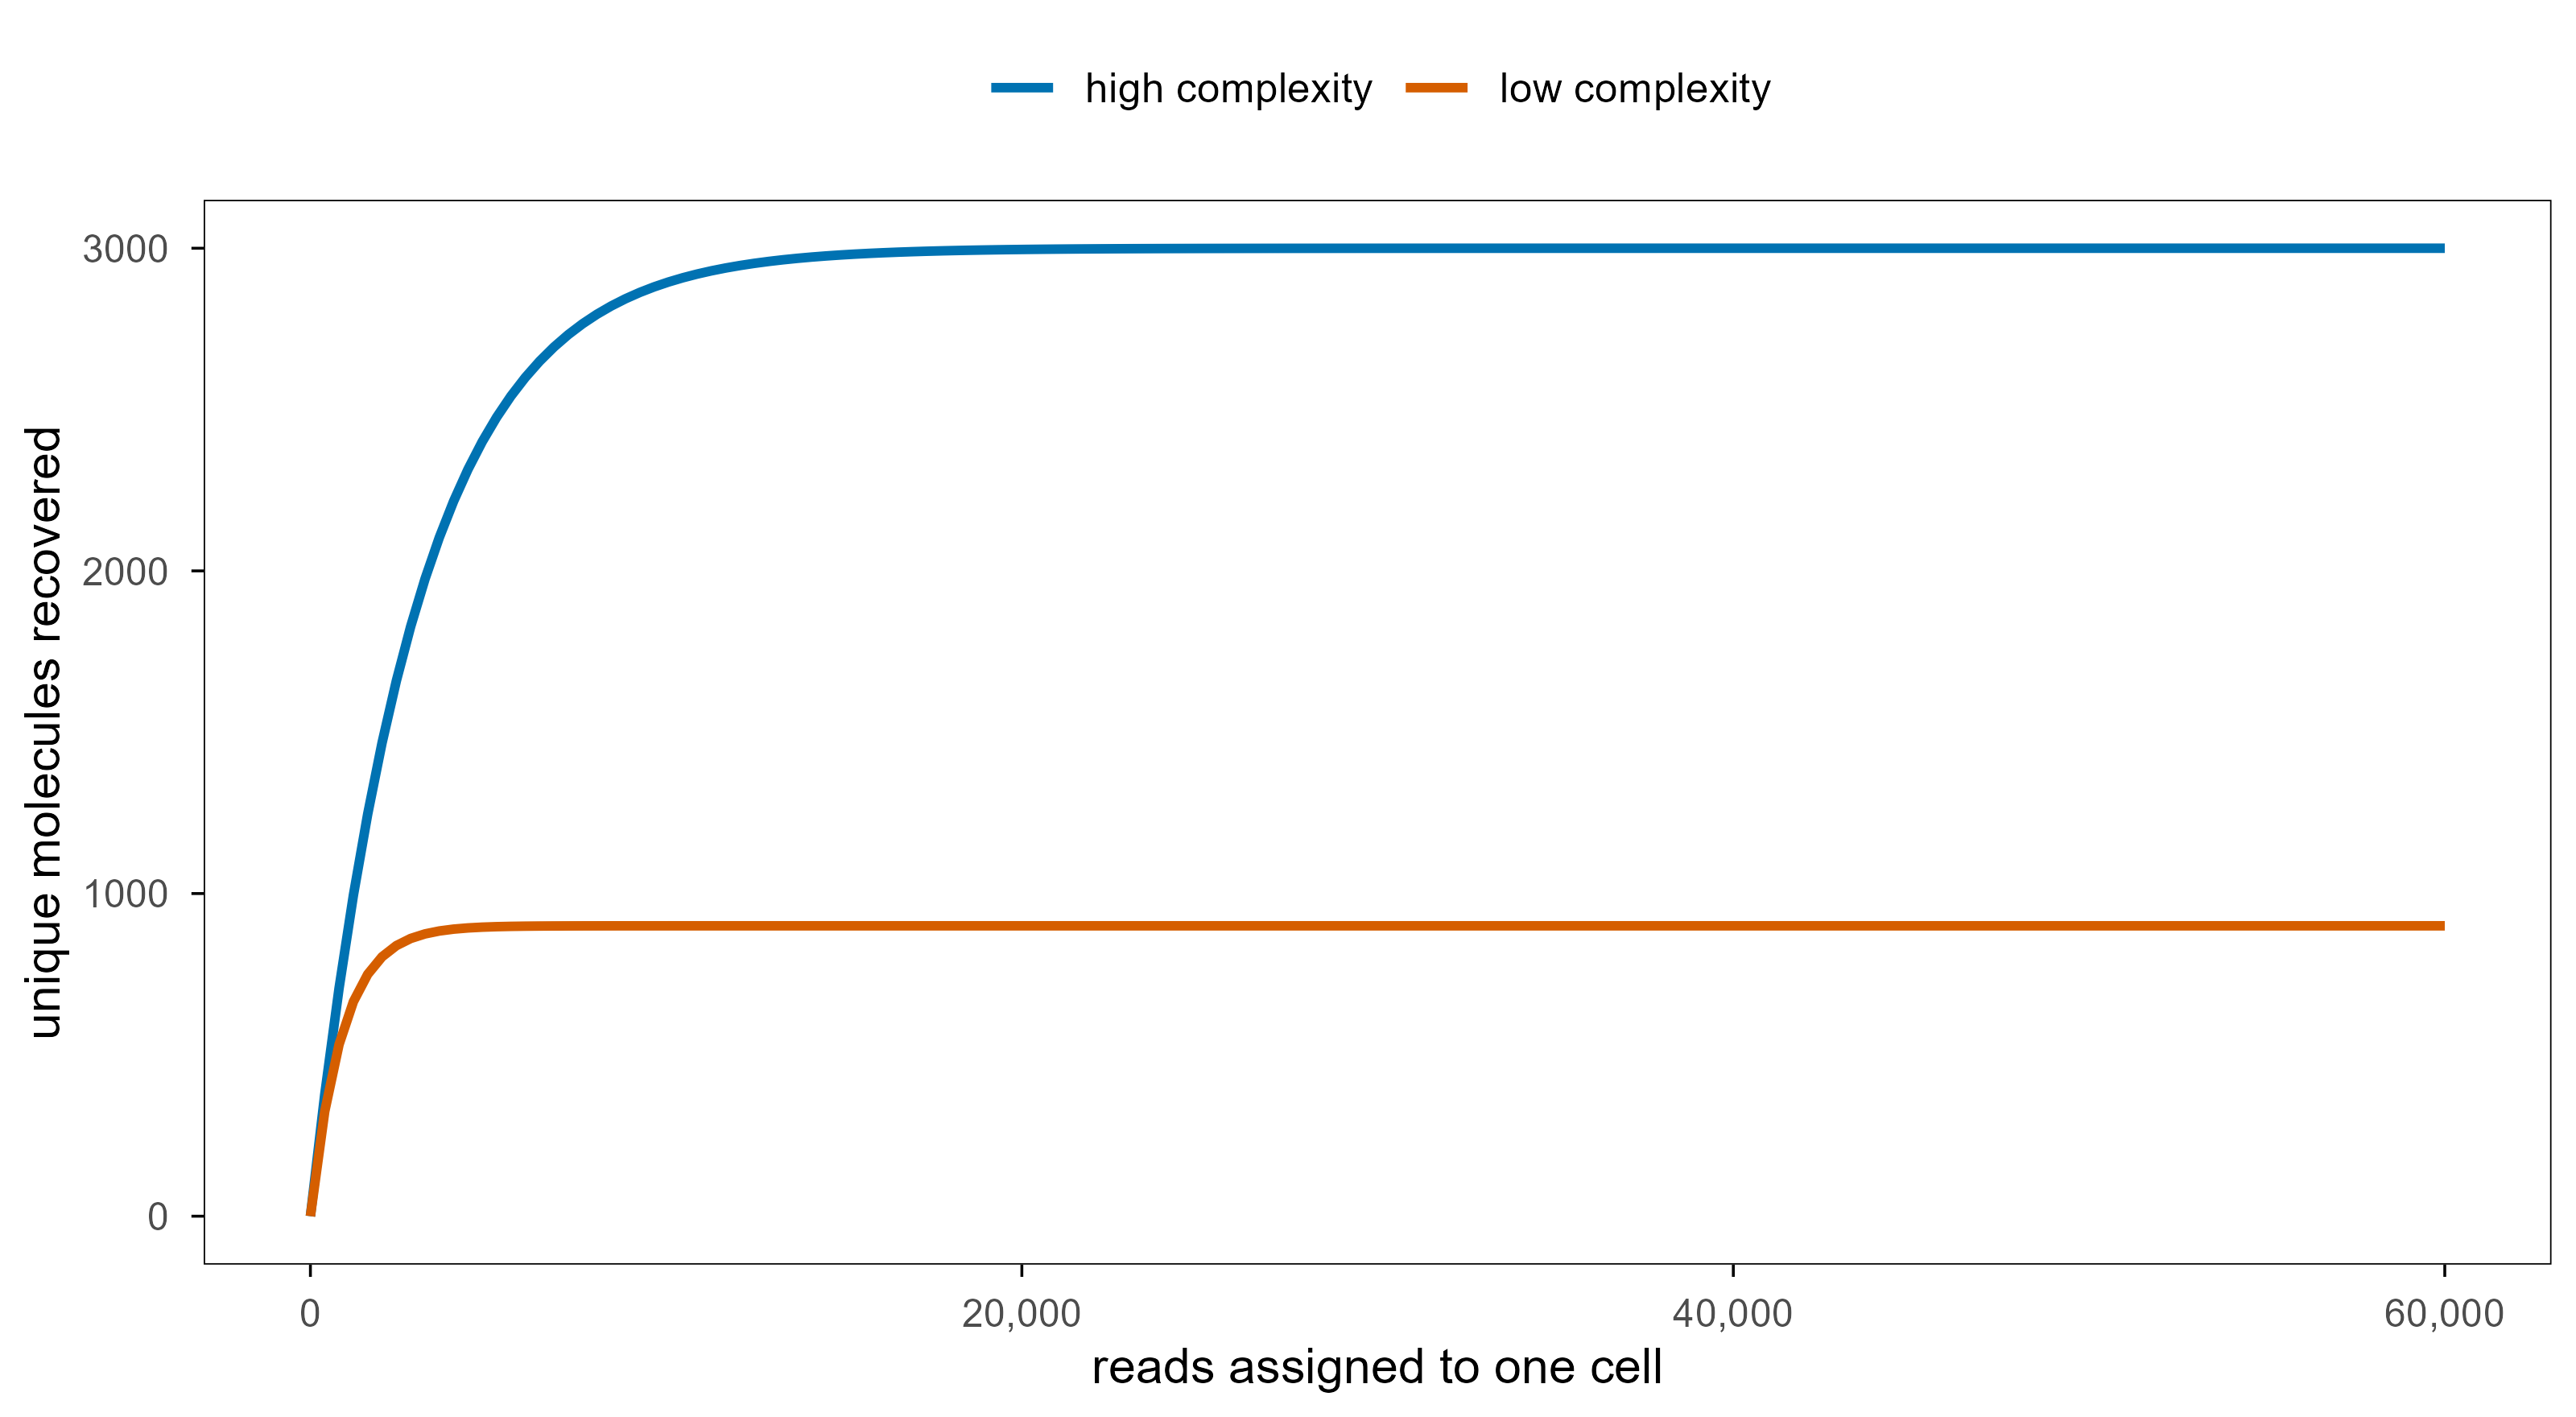
测序越深,同一个细胞里被重复测到的分子越多,新增的 reads 能带来的新分子越来越少。这条饱和曲线决定了“要不要继续加测序量”。
<- seq (0 , 60000 , length.out = 150 )<- bind_rows (data.frame (depth = depth, molecules = 3000 * (1 - exp (- depth / 3000 )), cell = "high complexity" ),data.frame (depth = depth, molecules = 900 * (1 - exp (- depth / 900 )), cell = "low complexity" )ggplot (sat, aes (depth, molecules, colour = cell)) + geom_line (linewidth = 1 ) + scale_colour_manual (values = c (blog_pal[["blue" ]], blog_pal[["vermillion" ]])) + scale_x_continuous (labels = label_comma ()) + labs (x = "reads assigned to one cell" , y = "unique molecules recovered" ,colour = NULL
8.4 空液滴识别
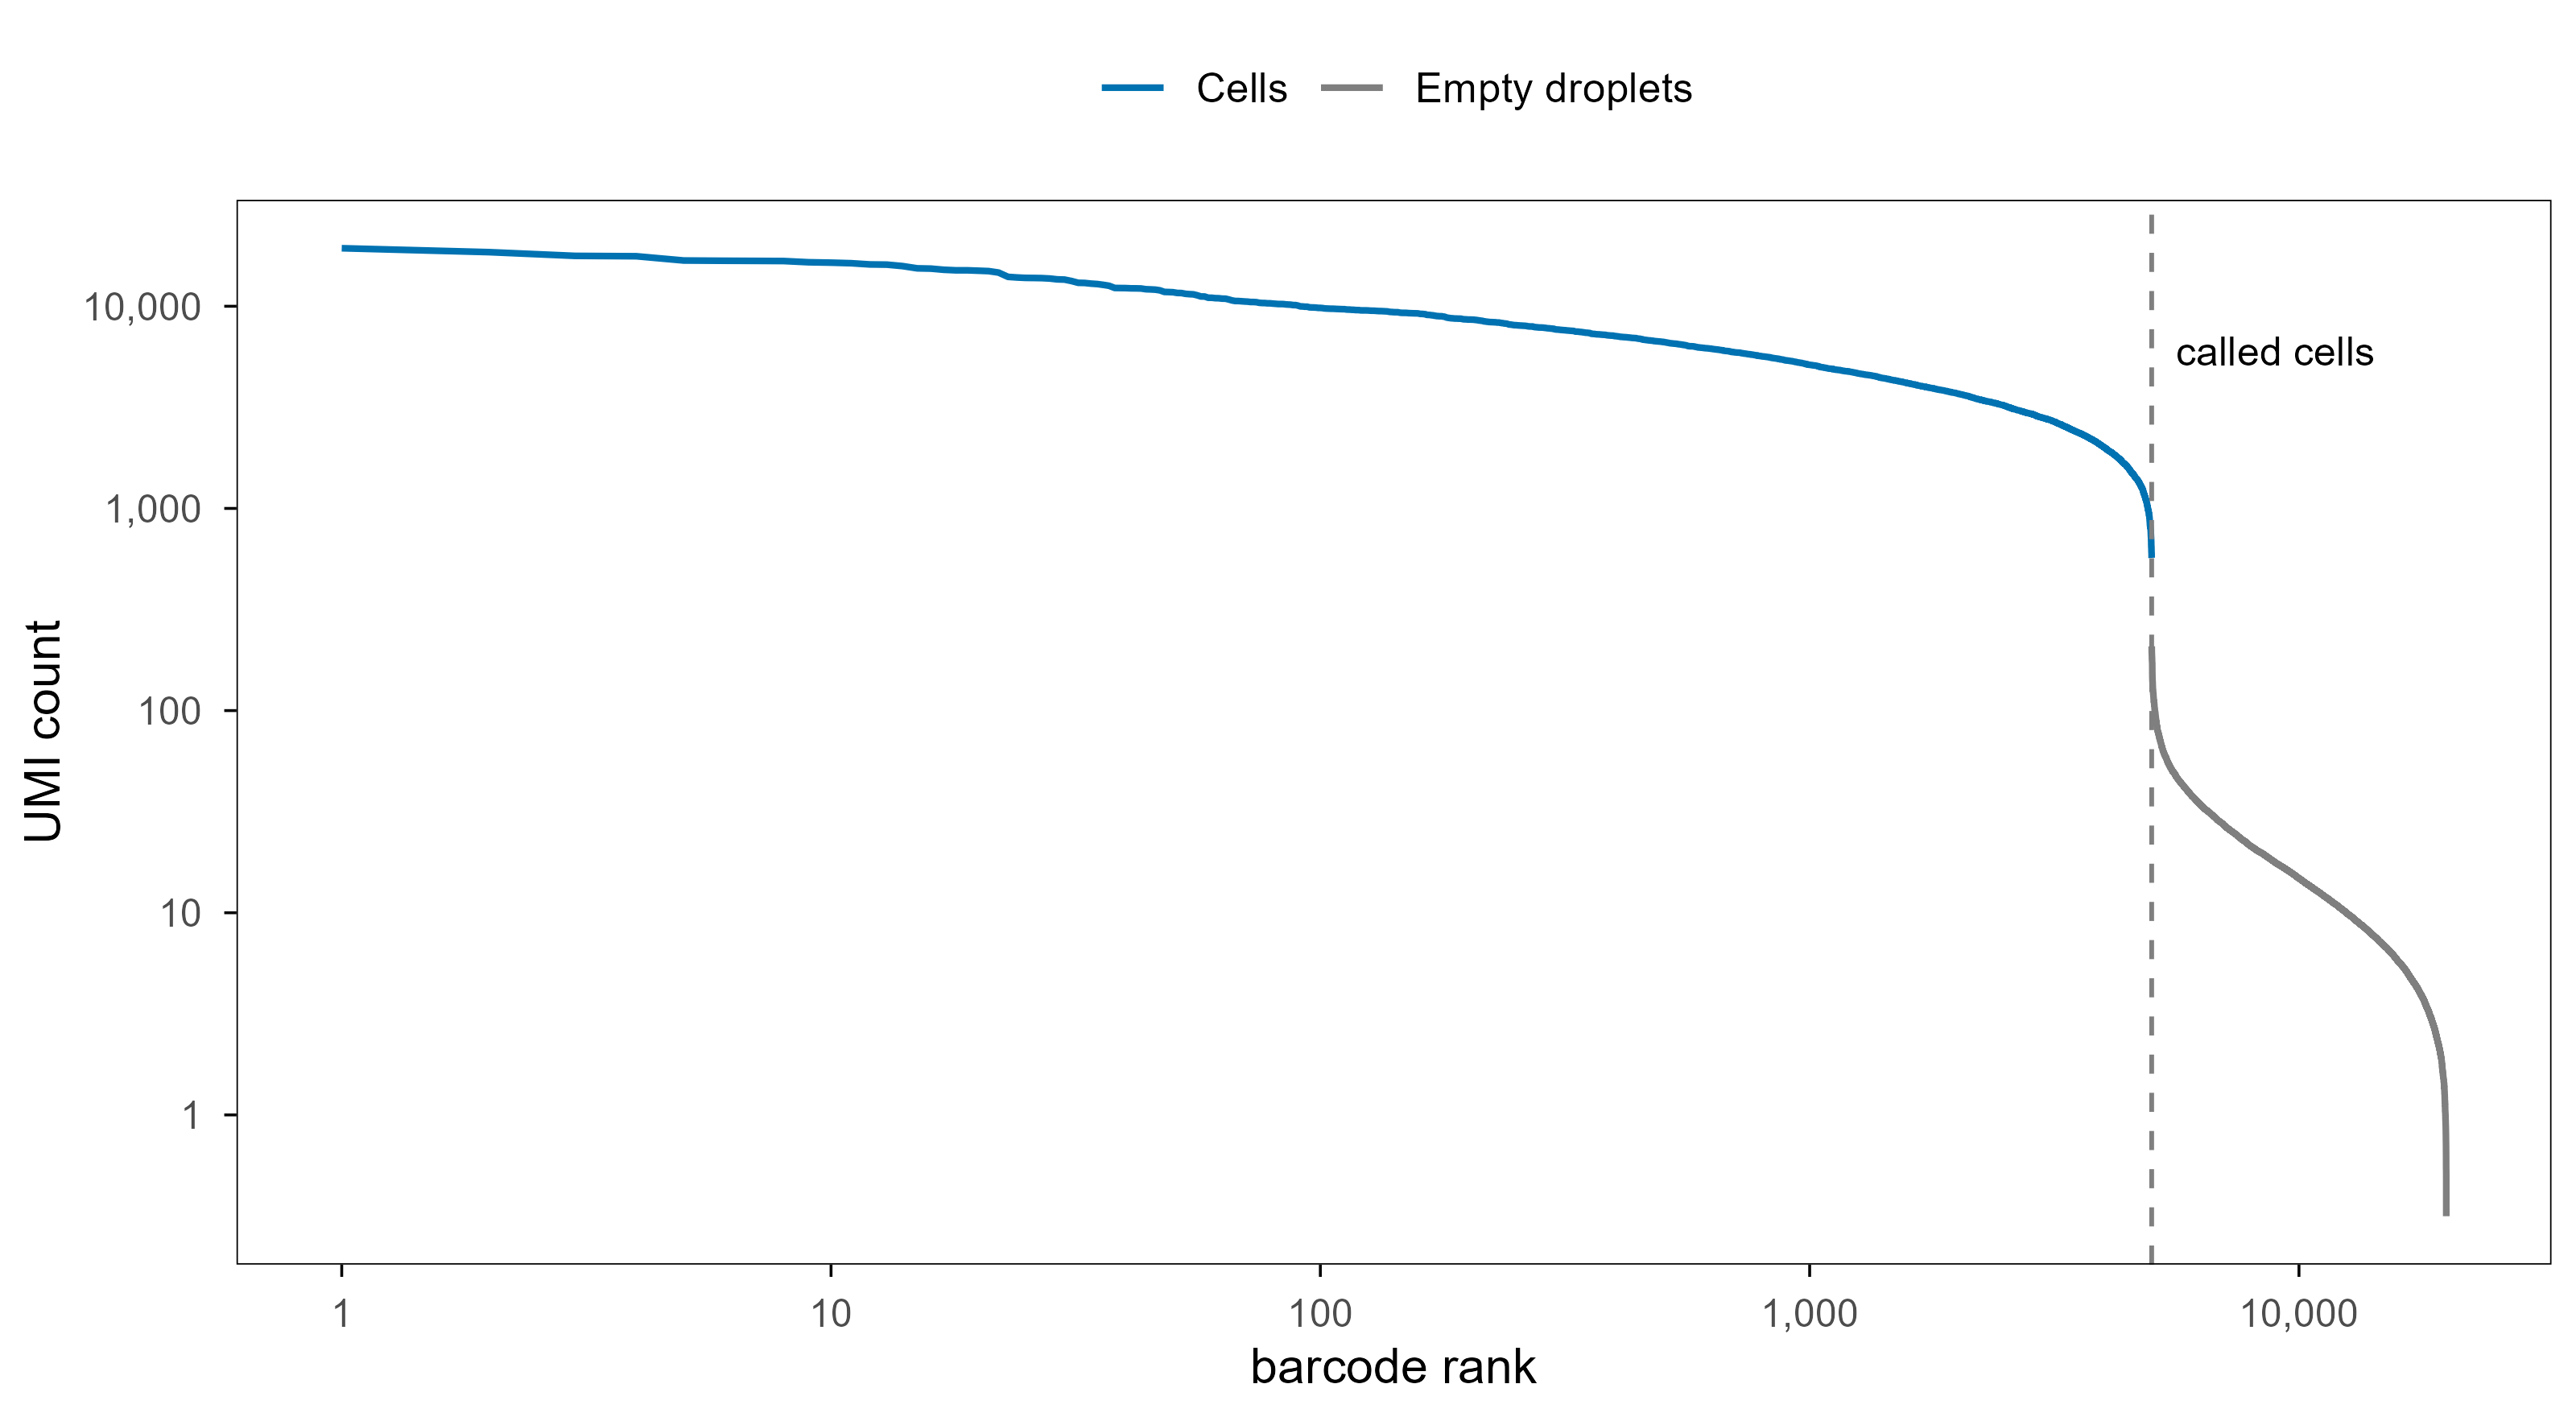
液滴测序里绝大多数条码来自不含细胞的空液滴 ,它们只有少量背景 RNA。区分“真细胞”和“空液滴”靠的是条码秩图(knee plot):按 UMI 数给条码排序,真细胞会形成一段平台,空液滴迅速掉到背景水平。
<- rlnorm (5000 , log (3200 ), 0.55 )<- rlnorm (15000 , log (10 ), 0.9 )<- sort (c (cell_umi, empty_umi), decreasing = TRUE )<- data.frame (rank = seq_along (umi_all),umi = umi_all,type = rep (c ("Cells" , "Empty droplets" ), c (5000 , 15000 ))ggplot (knee, aes (rank, umi, colour = type)) + geom_line (linewidth = 0.7 ) + geom_vline (xintercept = 5000 , linetype = "dashed" , colour = blog_pal[["grey" ]]) + annotate ("text" , x = 5600 , y = 6000 , label = "called cells" , hjust = 0 , size = 3.2 ) + scale_x_log10 (labels = label_comma ()) + scale_y_log10 (labels = label_comma ()) + scale_colour_manual (values = c (blog_pal[["blue" ]], blog_pal[["grey" ]])) + labs (x = "barcode rank" , y = "UMI count" , colour = NULL )
Cell Ranger 的固定阈值(例如 UMI ≥ 500)在低深度或高背景样本里经常失效。更稳健的方法是 EmptyDrops :对每个条码检验其基因表达谱是否显著偏离背景,而不是只看总 UMI 数。
8.5 输出与稀疏性
最终产物是三个文件:matrix.mtx(稀疏矩阵)、barcodes.tsv(细胞)、features.tsv(基因)。一个细胞通常只检测到 1,000–5,000 个基因,而人类基因组有两万多个蛋白编码基因,所以矩阵的稀疏度通常在 85%–95%。
从这一步开始,所有分析都建立在稀疏矩阵 上。任何把矩阵转成 dense data.frame 的操作,在十万级细胞时都会直接爆内存。
9. 质控:先把不是细胞的、坏掉的细胞去掉
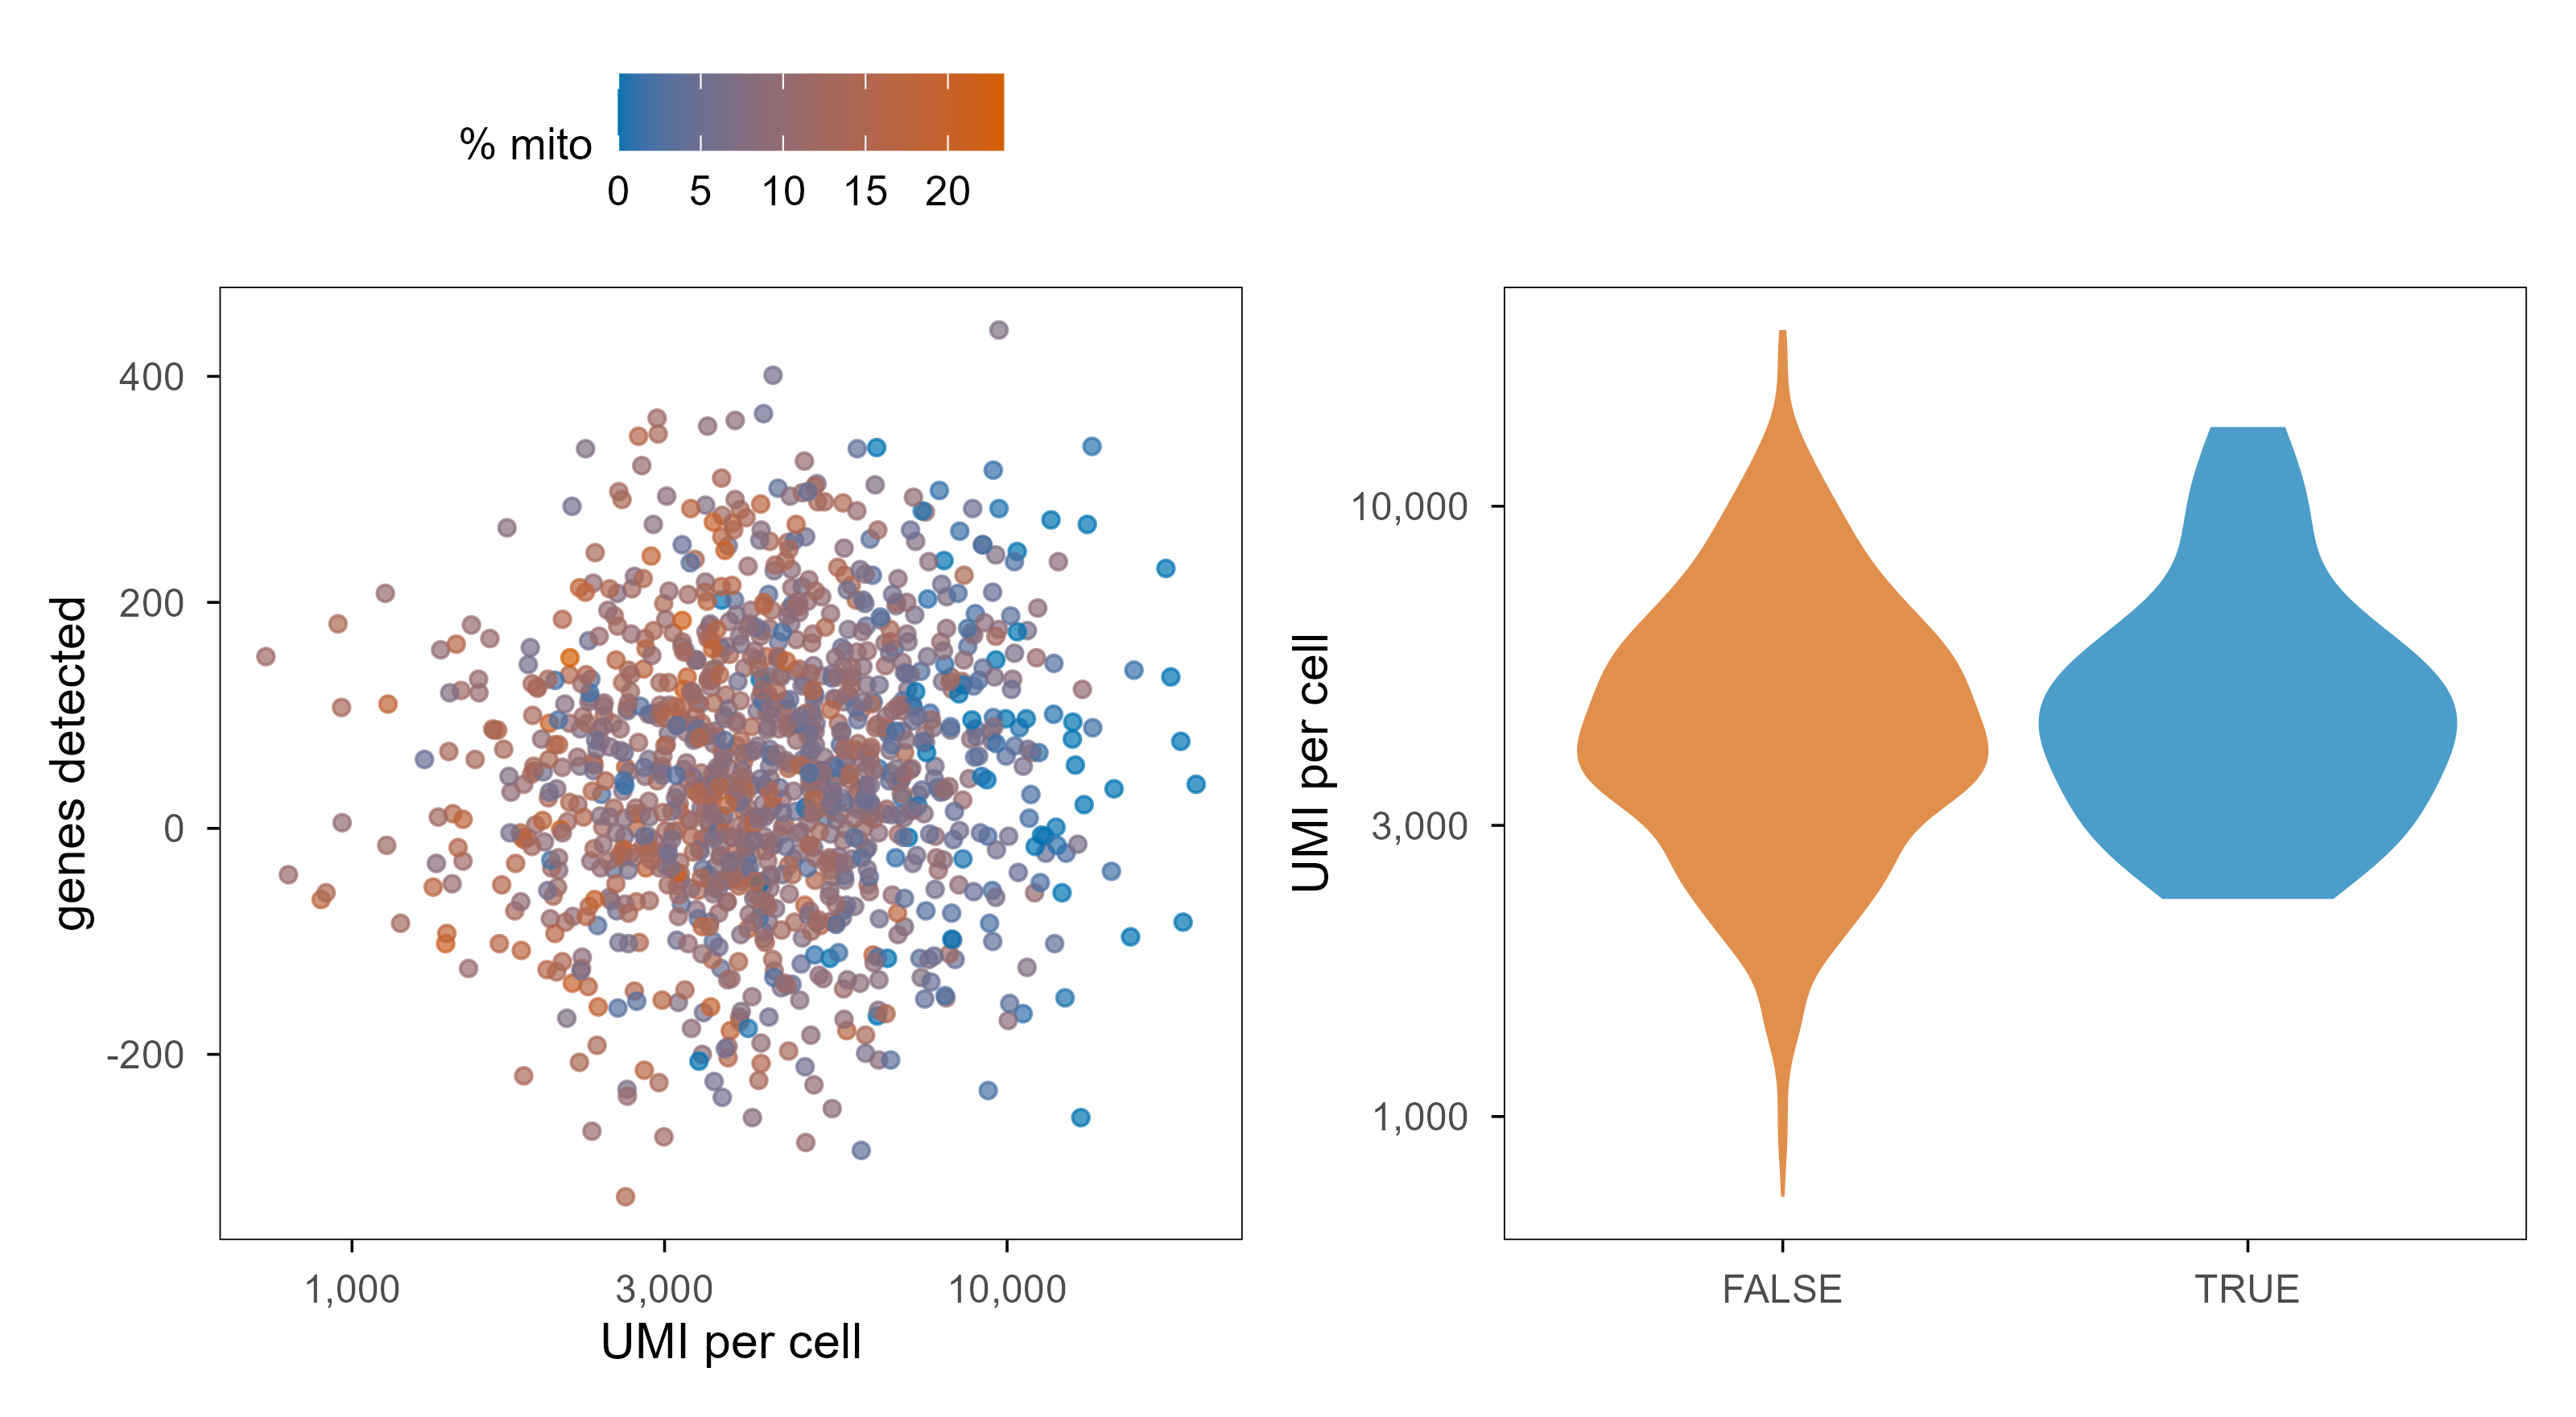
拿到矩阵后第一件事不是聚类,而是 QC。常用指标:
每个细胞的 UMI 总数 :太低是空液滴或破损细胞,太高可能是双细胞。检测到的基因数 :和 UMI 数高度相关,但能暴露低复杂度文库。线粒体基因比例 :细胞膜破损时胞质 RNA 流失,线粒体转录本占比升高。不同组织阈值差异很大(2%–20%)。核糖体基因比例 :过高可能提示 rRNA 污染或特定状态。双细胞(doublet) :两个细胞进了同一个液滴,会表现成“混合表达”的假细胞。
set.seed (21 )<- 1200 <- rlnorm (n, log (4200 ), 0.5 )<- data.frame (counts = counts_total,genes = round (counts_total^ 0.62 / 4 + rnorm (n, 0 , 120 )),mito = pmax (0 , rnorm (n, 14 - 0.001 * counts_total, 4 ))$ pass <- qc$ counts > 1000 & qc$ genes > 300 & qc$ mito < 20 <- ggplot (qc, aes (counts, genes, colour = mito)) + geom_point (size = 1.4 , alpha = 0.7 ) + scale_x_log10 (labels = label_comma ()) + scale_colour_gradient (low = blog_pal[["blue" ]], high = blog_pal[["vermillion" ]]) + labs (x = "UMI per cell" , y = "genes detected" , colour = "% mito" )<- ggplot (qc, aes (pass, counts, fill = pass)) + geom_violin (alpha = 0.7 , colour = NA ) + scale_y_log10 (labels = label_comma ()) + scale_fill_manual (values = c (blog_pal[["vermillion" ]], blog_pal[["blue" ]])) + labs (x = NULL , y = "UMI per cell" , fill = NULL ) + theme (legend.position = "none" )+ p2
阈值不建议直接抄“UMI > 1000、基因 > 500”。更稳妥的做法是按样本看分布 ,用 MAD(median absolute deviation)或分位数设阈值,并把过滤前后的细胞数、基因数记录下来。过度过滤会系统性丢掉低 RNA 含量的真实细胞(例如静息 T 细胞、红细胞、某些神经元)。
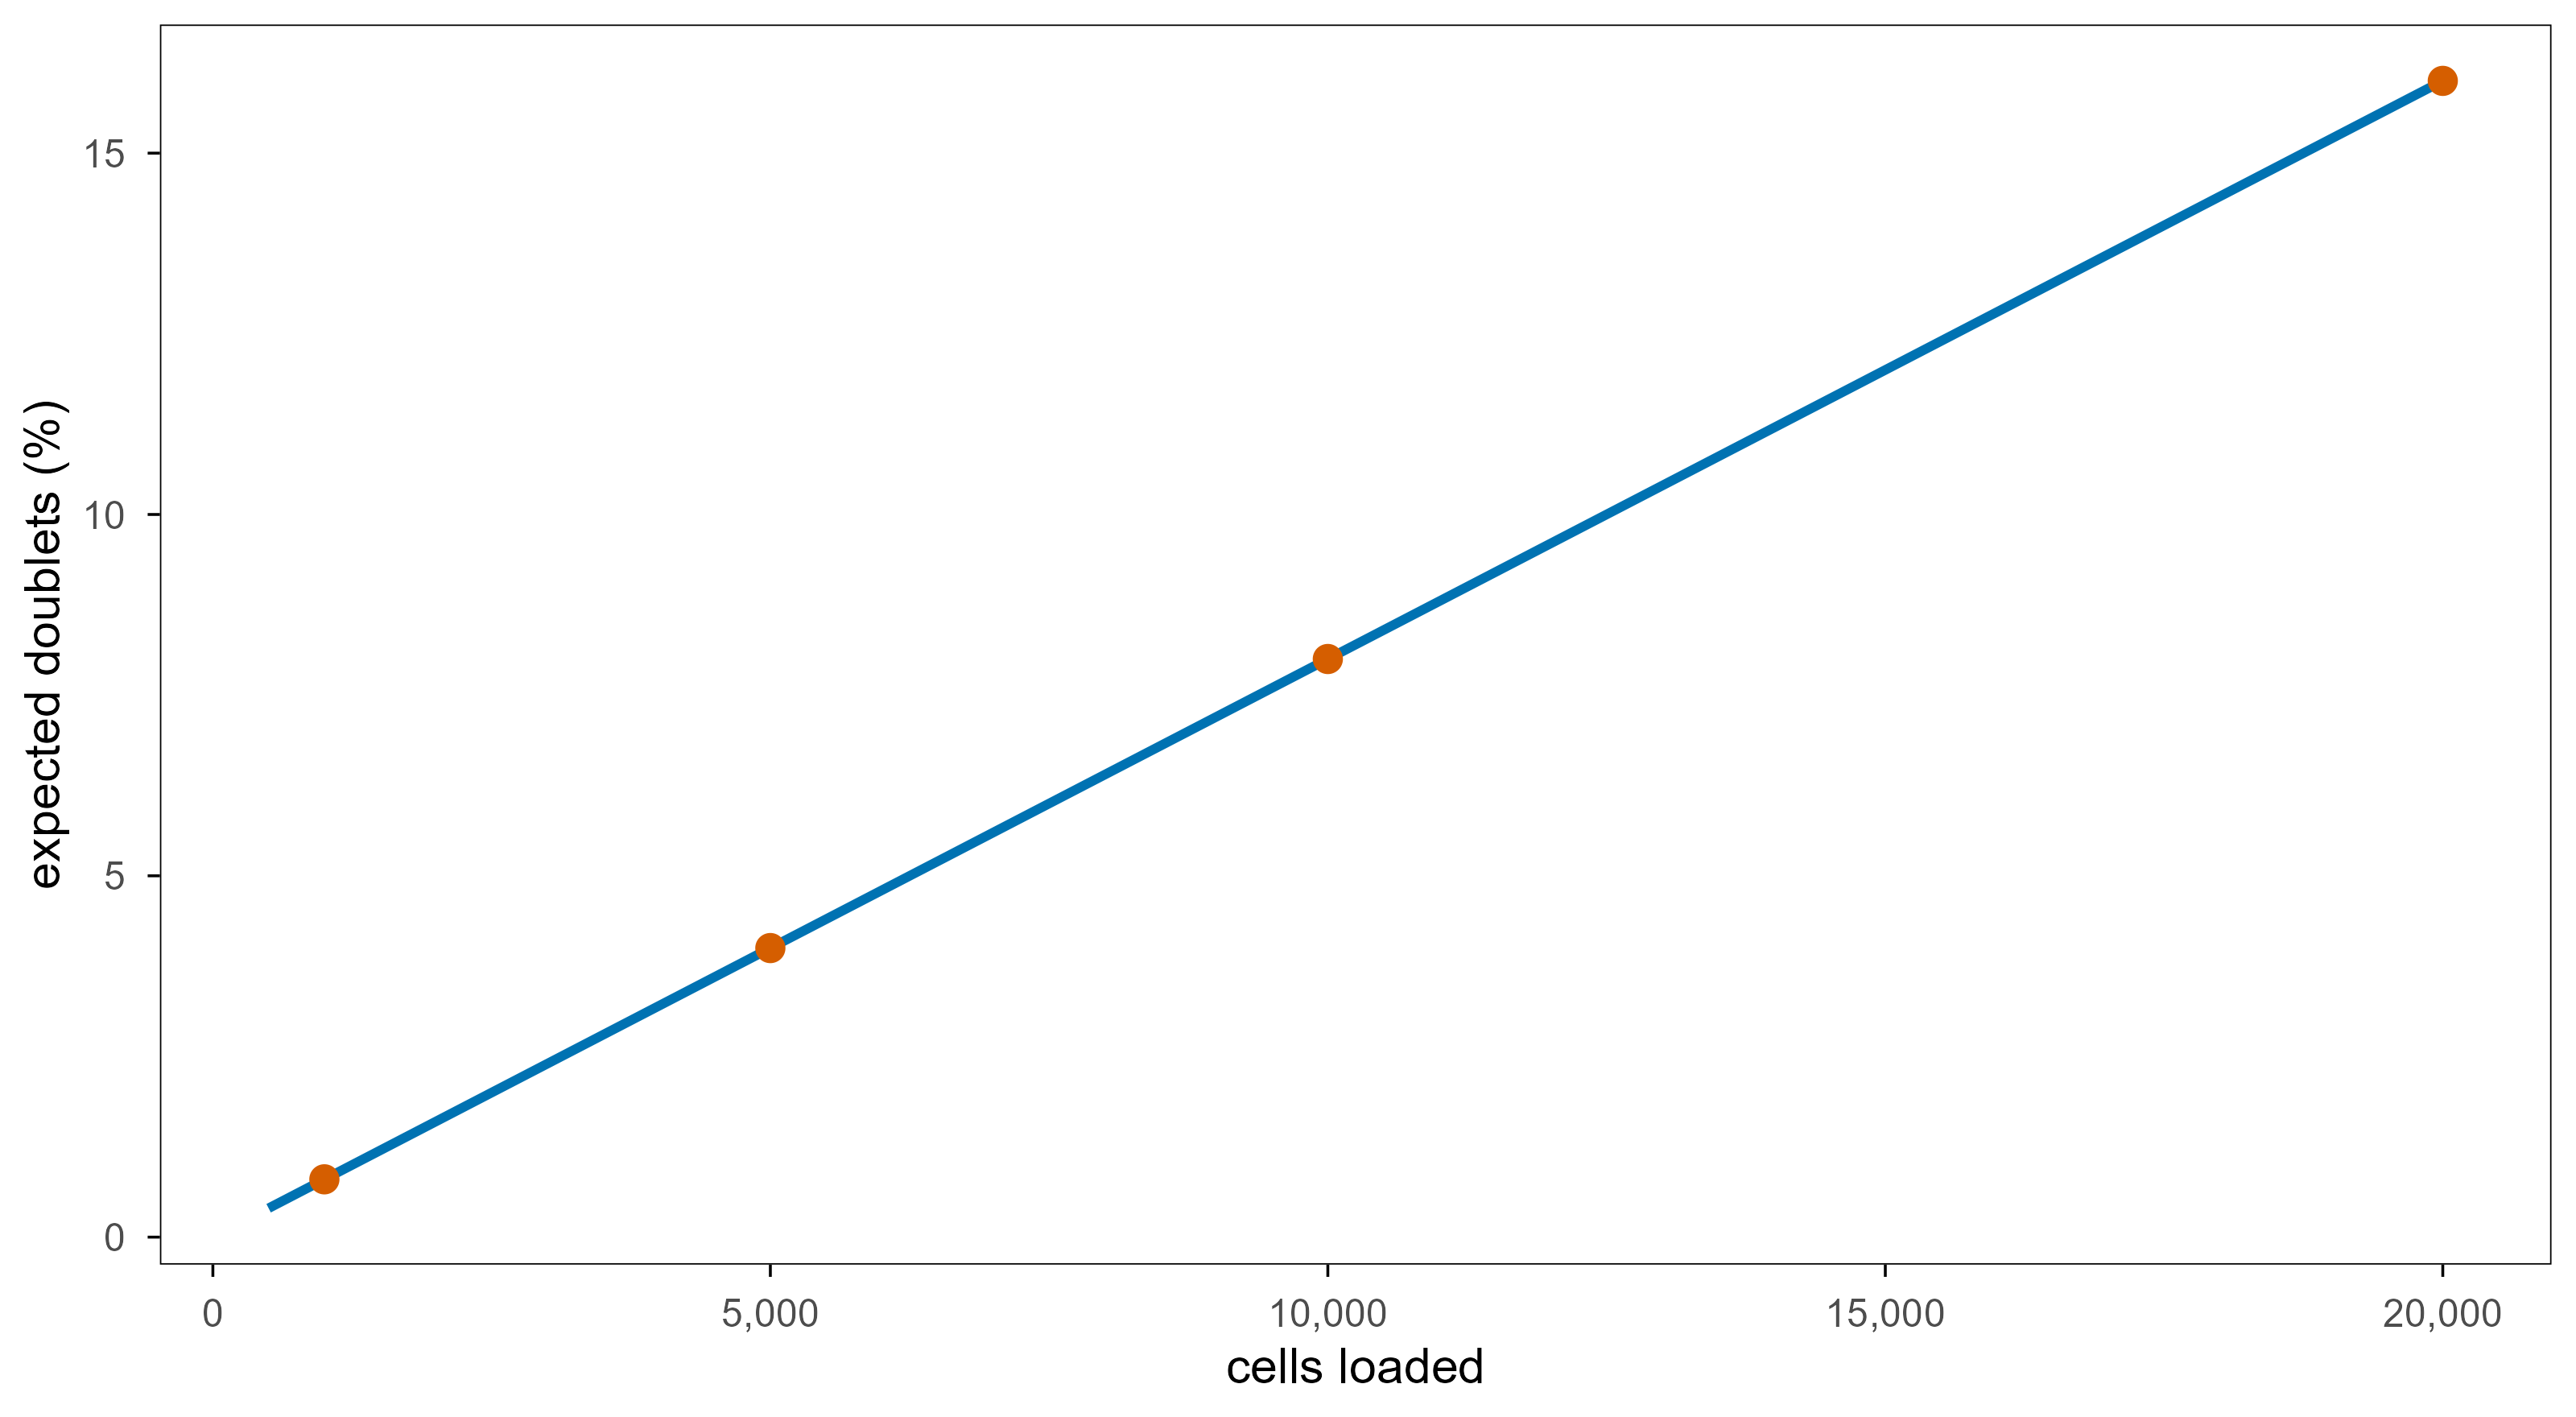
双细胞率随上样细胞数上升。10x 的经验公式大致是每 1,000 个细胞约 0.8%,所以 10,000 个细胞里可能有 800 个左右的 doublet,需要用 Scrublet、DoubletFinder 或 scDblFinder 检测。
<- seq (500 , 20000 , by = 500 )<- data.frame (cells = cells, rate = 0.008 * cells / 1000 )ggplot (doublet, aes (cells, rate * 100 )) + geom_line (colour = blog_pal[["blue" ]], linewidth = 1 ) + geom_point (data = data.frame (cells = c (1000 , 5000 , 10000 , 20000 )),aes (cells, 0.008 * cells / 1000 * 100 ),colour = blog_pal[["vermillion" ]], size = 2.5 + scale_x_continuous (labels = label_comma ()) + labs (x = "cells loaded" , y = "expected doublets (%)" )
还有一类污染不容易在 QC 图里看到:ambient RNA 。空液滴里的游离 RNA 会附着到真细胞上,让所有细胞都“表达”某些高丰度基因(例如血红蛋白、白蛋白、免疫球蛋白)。SoupX、CellBender 可以估计背景并扣除。判断方法是看空液滴矩阵里哪些基因最高,以及这些基因是否在所有细胞类型里均匀出现。
10. 标准化、特征选择、降维、聚类
原始 UMI 计数受三个因素影响:细胞本身的 RNA 总量、捕获效率、测序深度。所以要先标准化,再做降维。
10.1 标准化
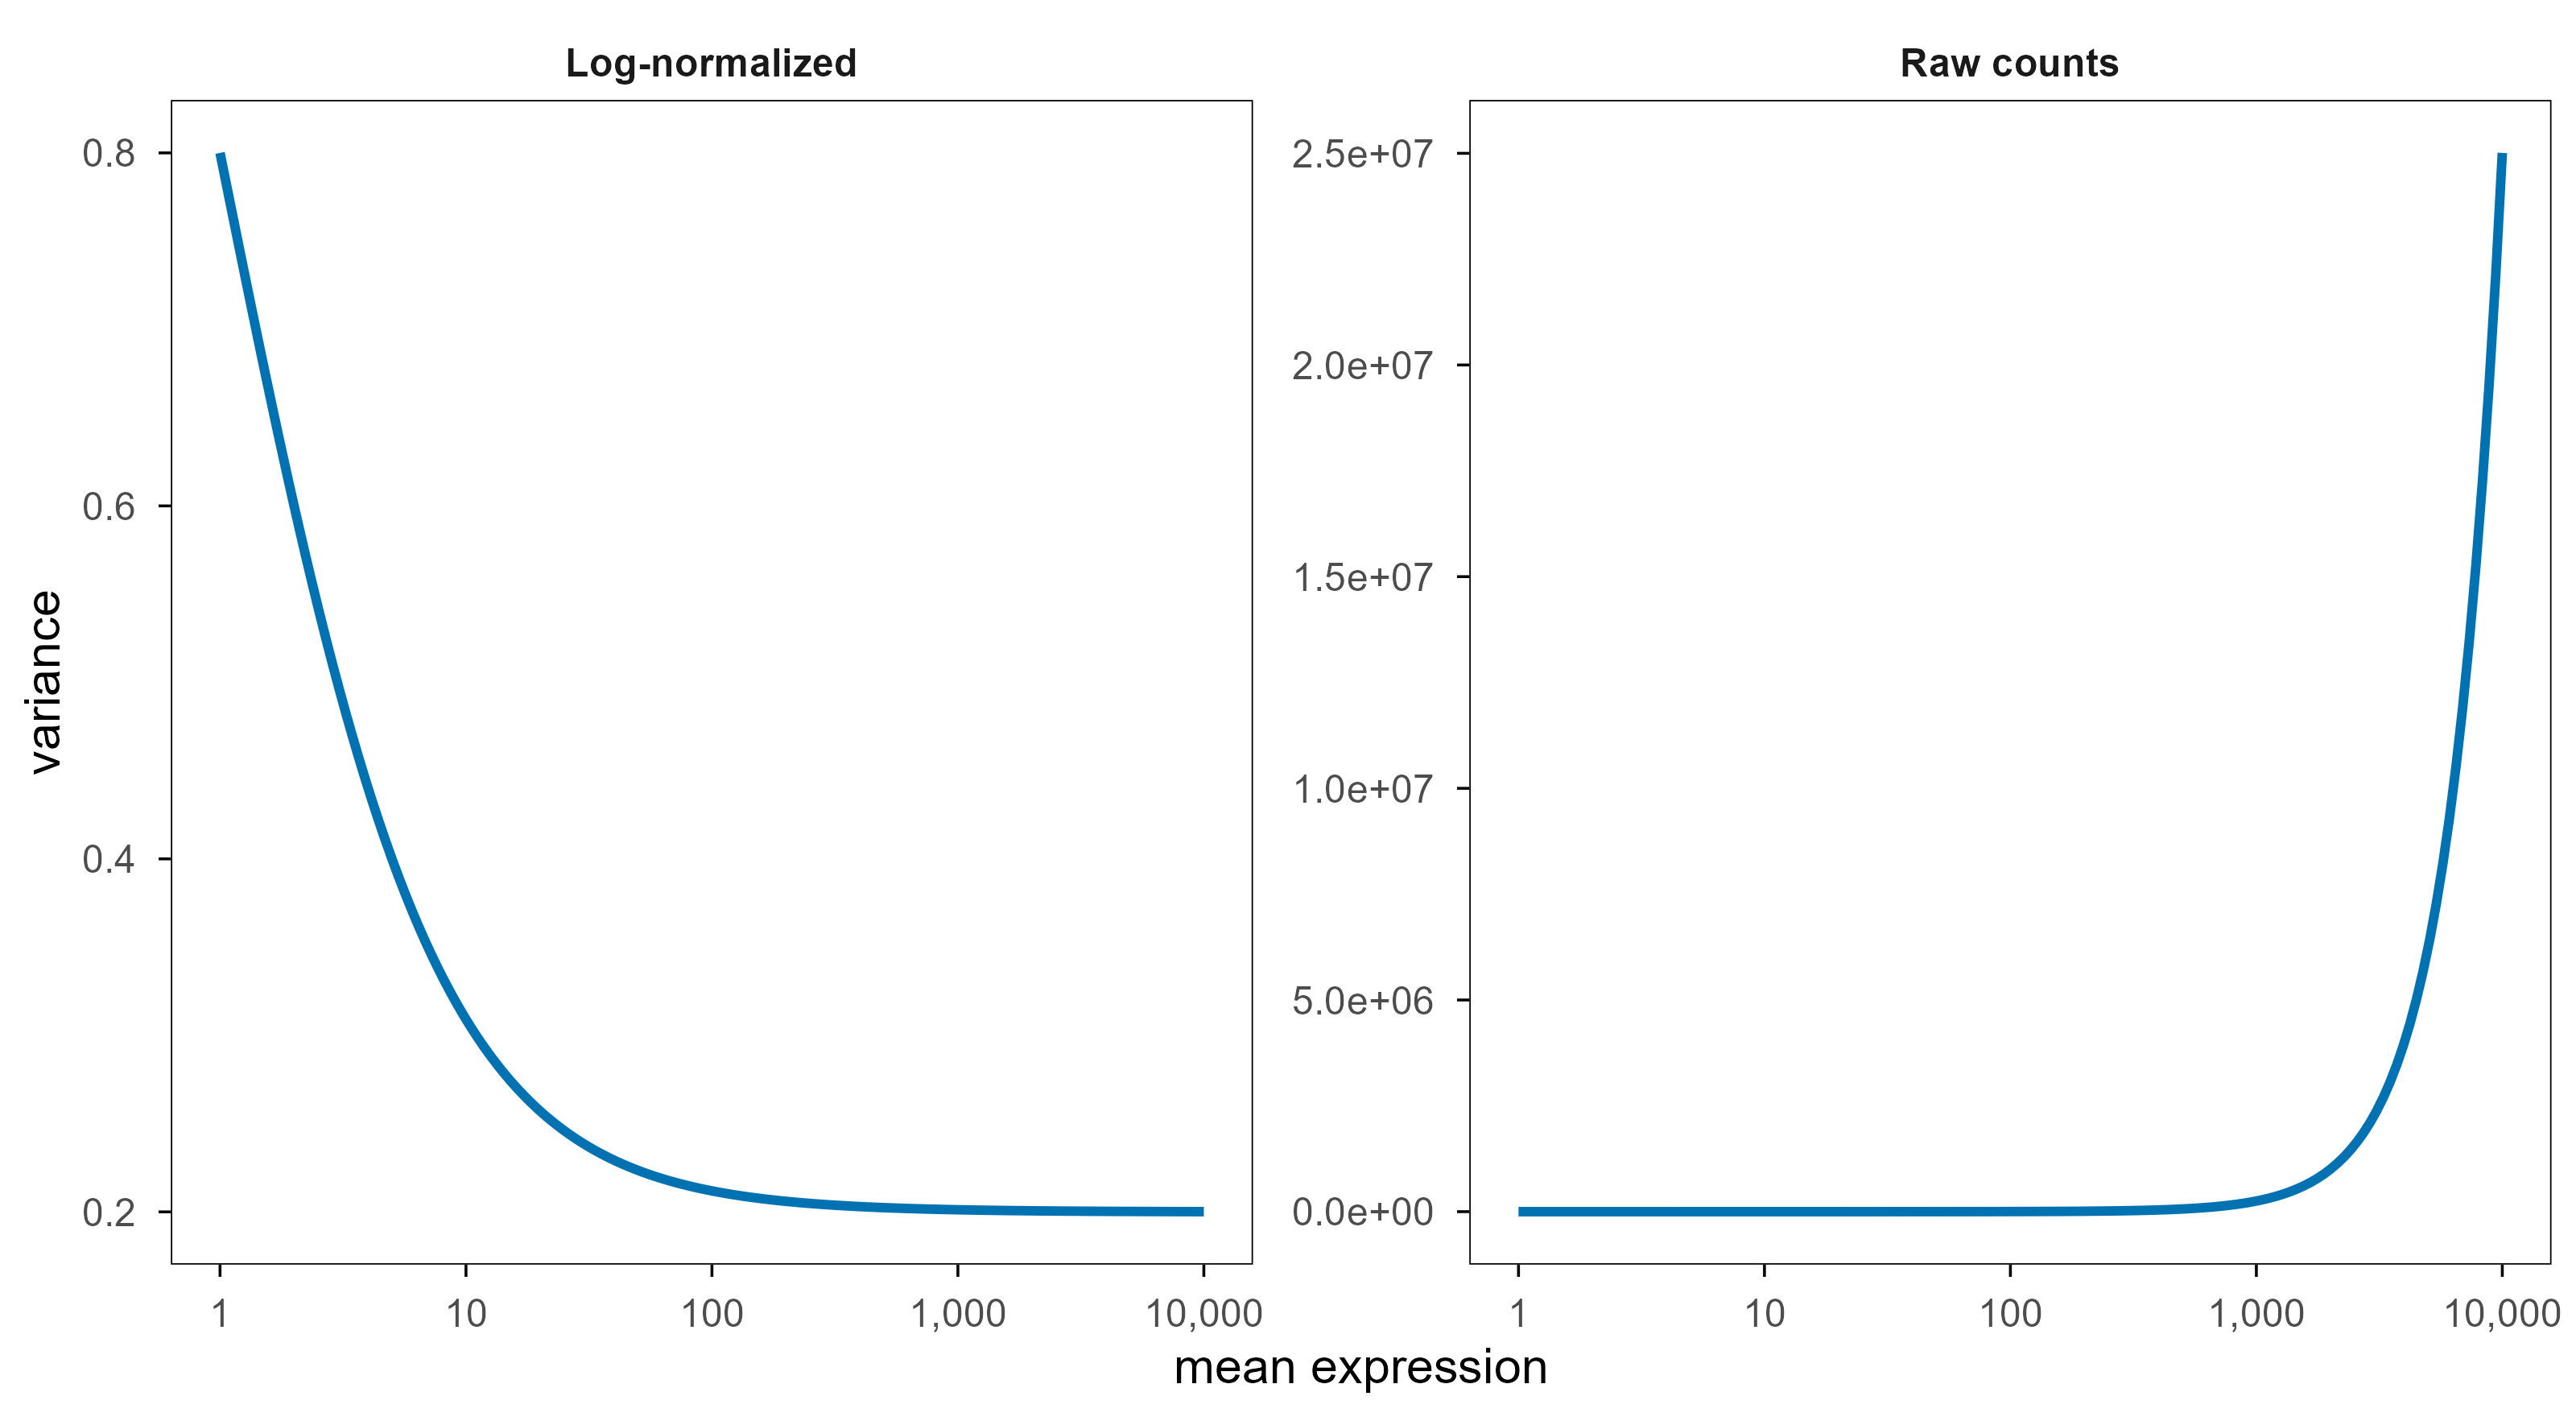
最常见的做法是 library-size normalization + log1p :每个细胞除以总计数,乘一个常数(常用 10,000),再取 log1p。它的作用是把“均值–方差”关系拉平,让高表达基因不再天然占据全部方差。
<- 10 ^ seq (0 , 4 , length.out = 150 )<- bind_rows (data.frame (mean = mu, variance = mu + (0.5 * mu)^ 2 , method = "Raw counts" ),data.frame (mean = mu, variance = 0.2 + 1.2 / (mu + 1 ), method = "Log-normalized" )ggplot (mv, aes (mean, variance)) + geom_line (colour = blog_pal[["blue" ]], linewidth = 1 ) + facet_wrap (~ method, scales = "free_y" ) + scale_x_log10 (labels = label_comma ()) + labs (x = "mean expression" , y = "variance" )
其他常用方案:
scran pooling :先对细胞分组、用 pooled size factor 估计,适合细胞间 RNA 总量差异很大的数据。SCTransform / Pearson residuals :直接用负二项模型对计数建模,输出残差,避免 log 变换的偏差。scVI / totalVI :用变分自编码器学习低维表示,同时校正批次;适合十万级以上细胞。
10.2 特征选择
标准化之后选出高变基因(HVG),只保留信息量最大的 2,000–3,000 个基因。常用方法有 vst、mean.var.plot、dispersion,以及基于 Poisson 偏差的 scry。HVG 的选择会显著影响聚类结果,建议做敏感性分析(例如 1,000 / 2,000 / 4,000 个基因各跑一次)。
10.3 PCA、kNN 图与聚类
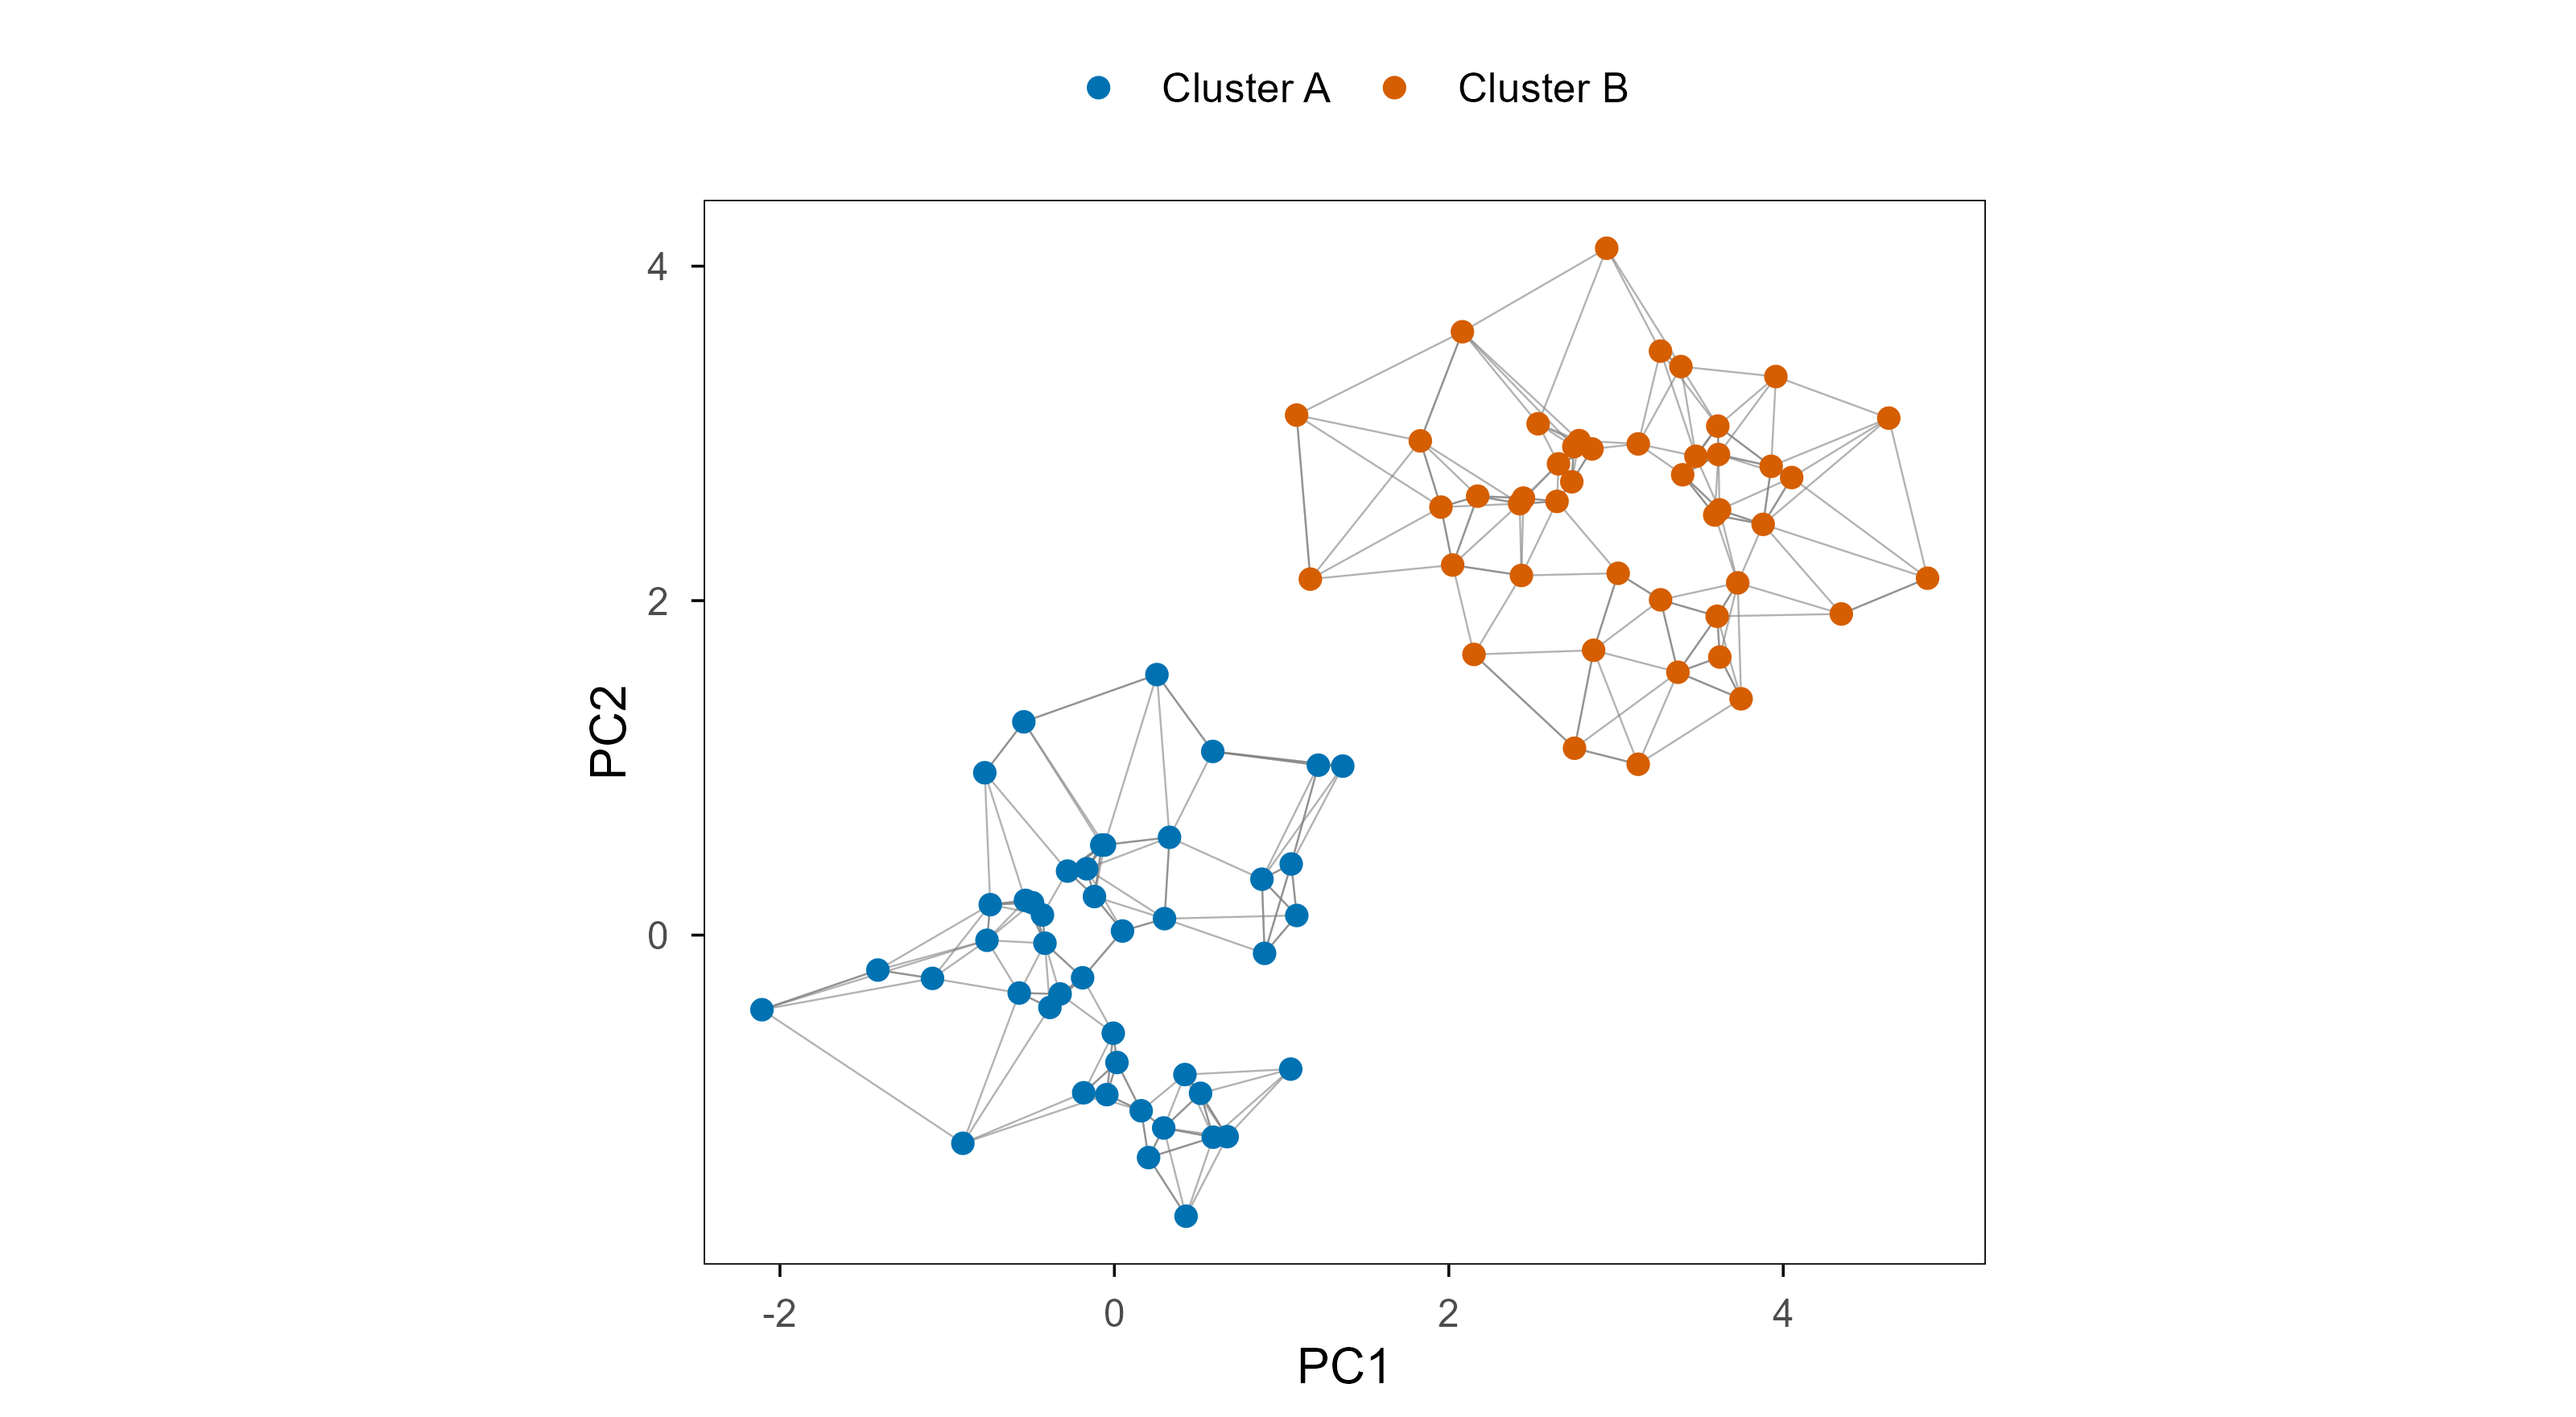
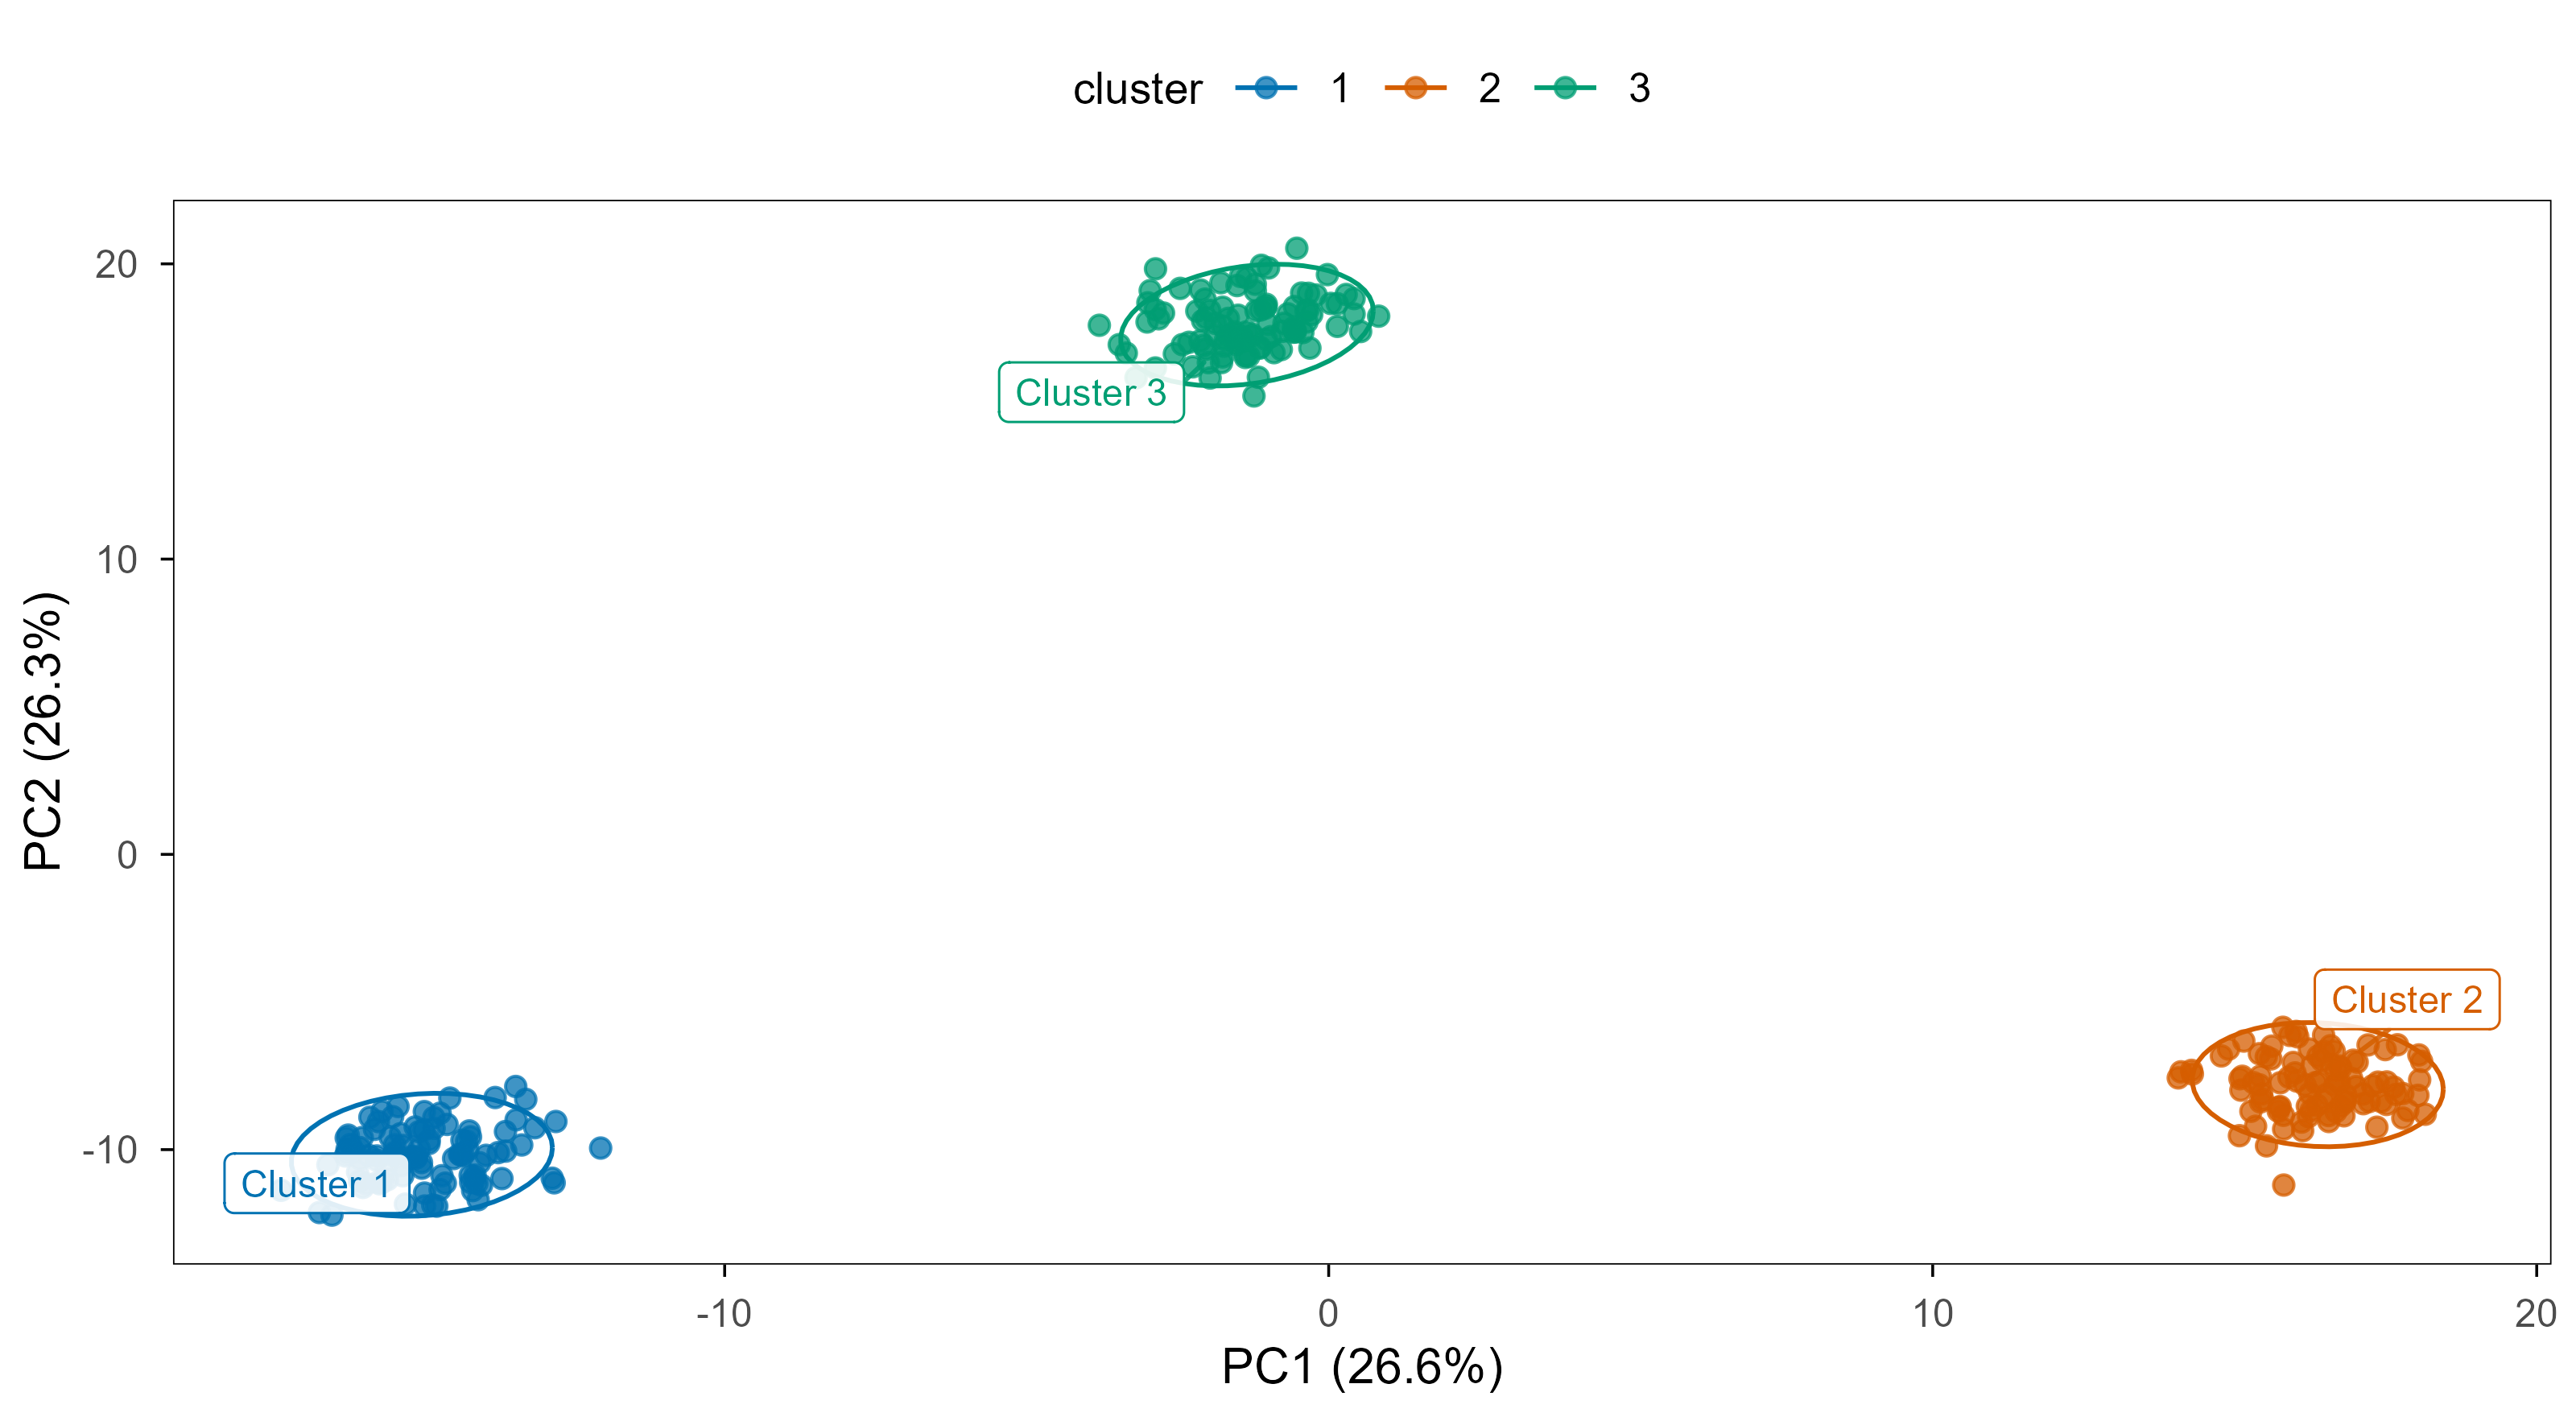
PCA 的前几十个主成分构成细胞的低维表示,在这个空间里建 kNN 图,用 Leiden/Louvain 做社区发现,就得到了聚类;UMAP 或 tSNE 只是把这个图再压到二维用来可视化。
set.seed (8 )<- data.frame (x = c (rnorm (45 , 0 , 0.7 ), rnorm (45 , 3.2 , 0.7 )),y = c (rnorm (45 , 0 , 0.7 ), rnorm (45 , 2.4 , 0.7 )),group = factor (rep (c ("Cluster A" , "Cluster B" ), each = 45 ))<- as.matrix (dist (pts[, c ("x" , "y" )]))<- 4 <- do.call (rbind, lapply (seq_len (nrow (pts)), function (i) {<- order (d[i, ])[2 : (k + 1 )]data.frame (x = pts$ x[i], y = pts$ y[i], xend = pts$ x[nn], yend = pts$ y[nn])ggplot (pts, aes (x, y)) + geom_segment (data = edges, aes (x = x, y = y, xend = xend, yend = yend),colour = blog_pal[["grey" ]], linewidth = 0.2 , alpha = 0.6 + geom_point (aes (colour = group), size = 1.8 ) + scale_colour_manual (values = c (blog_pal[["blue" ]], blog_pal[["vermillion" ]])) + coord_equal () + labs (x = "PC1" , y = "PC2" , colour = NULL )
set.seed (33 )<- 300 <- 100 <- function (i) {<- matrix (rnorm (genes * per, 5 , 1 ), nrow = genes)<- ((i - 1 ) * 40 + 1 ): (i * 40 )<- m[rows, ] + 3.5 <- do.call (cbind, lapply (1 : 3 , make_block))< 0 ] <- 0 <- prcomp (t (expr), center = TRUE , scale. = FALSE )<- kmeans (pca$ x[, 1 : 10 ], centers = 3 , nstart = 20 )<- data.frame (PC1 = pca$ x[, 1 ], PC2 = pca$ x[, 2 ], cluster = factor (km$ cluster))<- round (100 * summary (pca)$ importance[2 , 1 : 2 ], 1 )<- emb %>% group_by (cluster) %>% summarise (PC1 = mean (PC1), PC2 = mean (PC2), .groups = "drop" )ggplot (emb, aes (PC1, PC2, colour = cluster)) + geom_point (size = 1.8 , alpha = 0.75 ) + stat_ellipse (linewidth = 0.5 ) + :: geom_label_repel (data = centers,aes (label = paste ("Cluster" , cluster)),fill = "white" , alpha = 0.88 , label.size = 0.25 , size = 3 , seed = 1 ,point.padding = unit (0.8 , "lines" ), box.padding = 0.8 ,min.segment.length = 0 , show.legend = FALSE + scale_colour_manual (values = pal[1 : 3 ]) + labs (x = paste0 ("PC1 (" , var_pc[1 ], "%)" ),y = paste0 ("PC2 (" , var_pc[2 ], "%)" ),colour = "cluster"
关于聚类有三个常见误解:
分辨率不是越高越好 :Leiden 的 resolution 越大,簇越多;要结合 marker 和稳定性选择,而不是调到“看起来分得开”。UMAP 的距离不是生物学距离 :它只保留局部邻接关系,簇间距离和面积都不代表相似度或细胞数。聚类不是细胞类型 :一个 cluster 可以包含多个类型,一个类型也可以被拆成多个 cluster;注释需要 marker 或参考映射。
11. 注释细胞类型
聚类只给出 cluster 0、1、2,接下来才是生物学:这些 cluster 是什么细胞、处于什么状态。
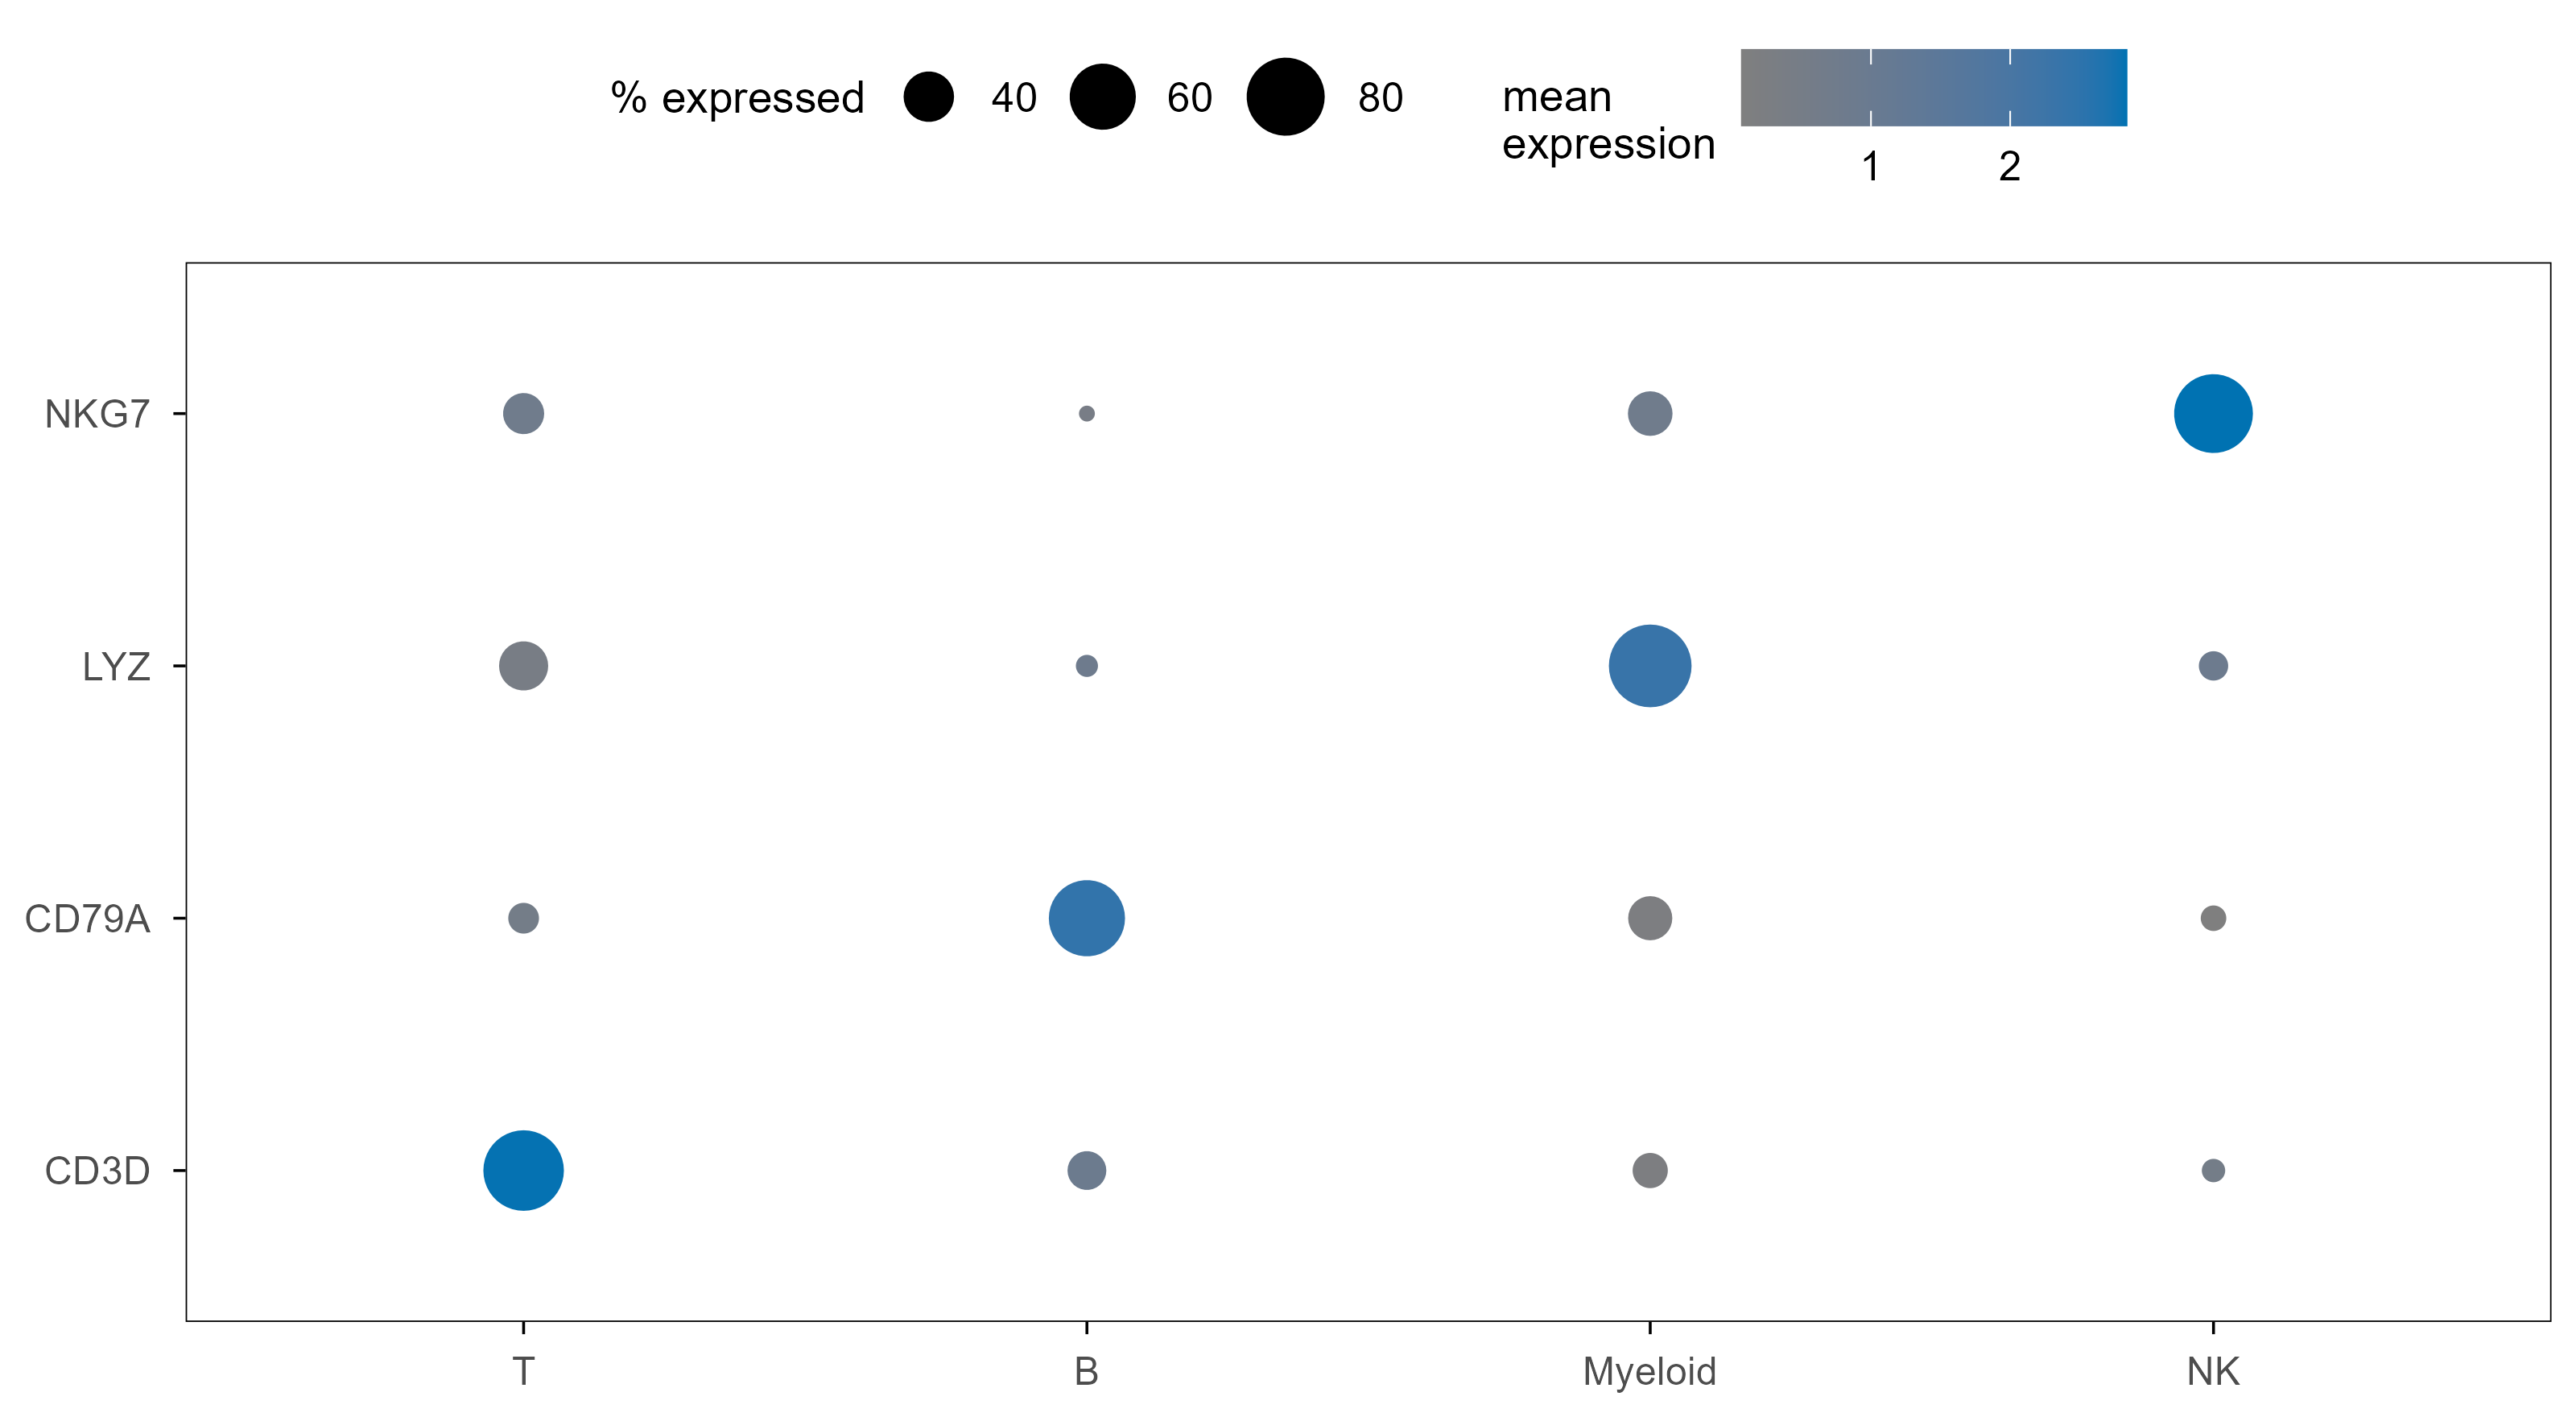
最常用的方法是标记基因 :看每个 cluster 里哪些基因特异高表达。把“表达比例”和“平均表达量”画成点图,是单细胞文章里最常见的图之一。
<- data.frame (gene = c ("CD3D" , "CD79A" , "LYZ" , "NKG7" ),cluster = c ("T" , "B" , "Myeloid" , "NK" )<- expand.grid (gene = markers$ gene, cluster = c ("T" , "B" , "Myeloid" , "NK" ))$ own <- markers$ cluster[match (grid$ gene, markers$ gene)] == grid$ clusterset.seed (4 )$ pct <- ifelse (grid$ own, runif (nrow (grid), 70 , 95 ), runif (nrow (grid), 5 , 40 ))$ avg <- ifelse (grid$ own, runif (nrow (grid), 1.5 , 3 ), runif (nrow (grid), 0 , 1 ))ggplot (grid, aes (cluster, gene)) + geom_point (aes (size = pct, colour = avg)) + scale_size_continuous (range = c (1 , 8 )) + scale_colour_gradient (low = blog_pal[["grey" ]], high = blog_pal[["blue" ]]) + labs (x = NULL , y = NULL , size = "% expressed" , colour = "mean \n expression" )
注释的三条路径:
人工 marker :可解释性最好,但依赖经验,且对稀有类型不敏感。参考映射 :把细胞投影到已注释的参考图谱(Azimuth、scType、CellTypist、scANVI),适合免疫、脑等有成熟图谱的组织。自动聚类 + 差异基因 :先找每个 cluster 的 top genes,再和文献/数据库比对。
注释之后建议做两件事:亚聚类 (在某个类型内部再分状态)和独立验证 (蛋白流式、原位杂交、空间转录组)。只靠同一批 marker 循环论证,是单细胞文章最常见的硬伤。
12. 细胞状态与动态过程
除了离散的标记基因,状态还可以用打分 来描述:细胞周期(S/G2M)、耗竭(exhaustion)、干扰素响应、缺氧、衰老……这些分数通常是一组基因的平均表达,在 UMAP 上用连续色阶展示。打分方法有 AddModuleScore、UCell、AUCell、GSVA,区别在于是否考虑背景表达和细胞间可比性。
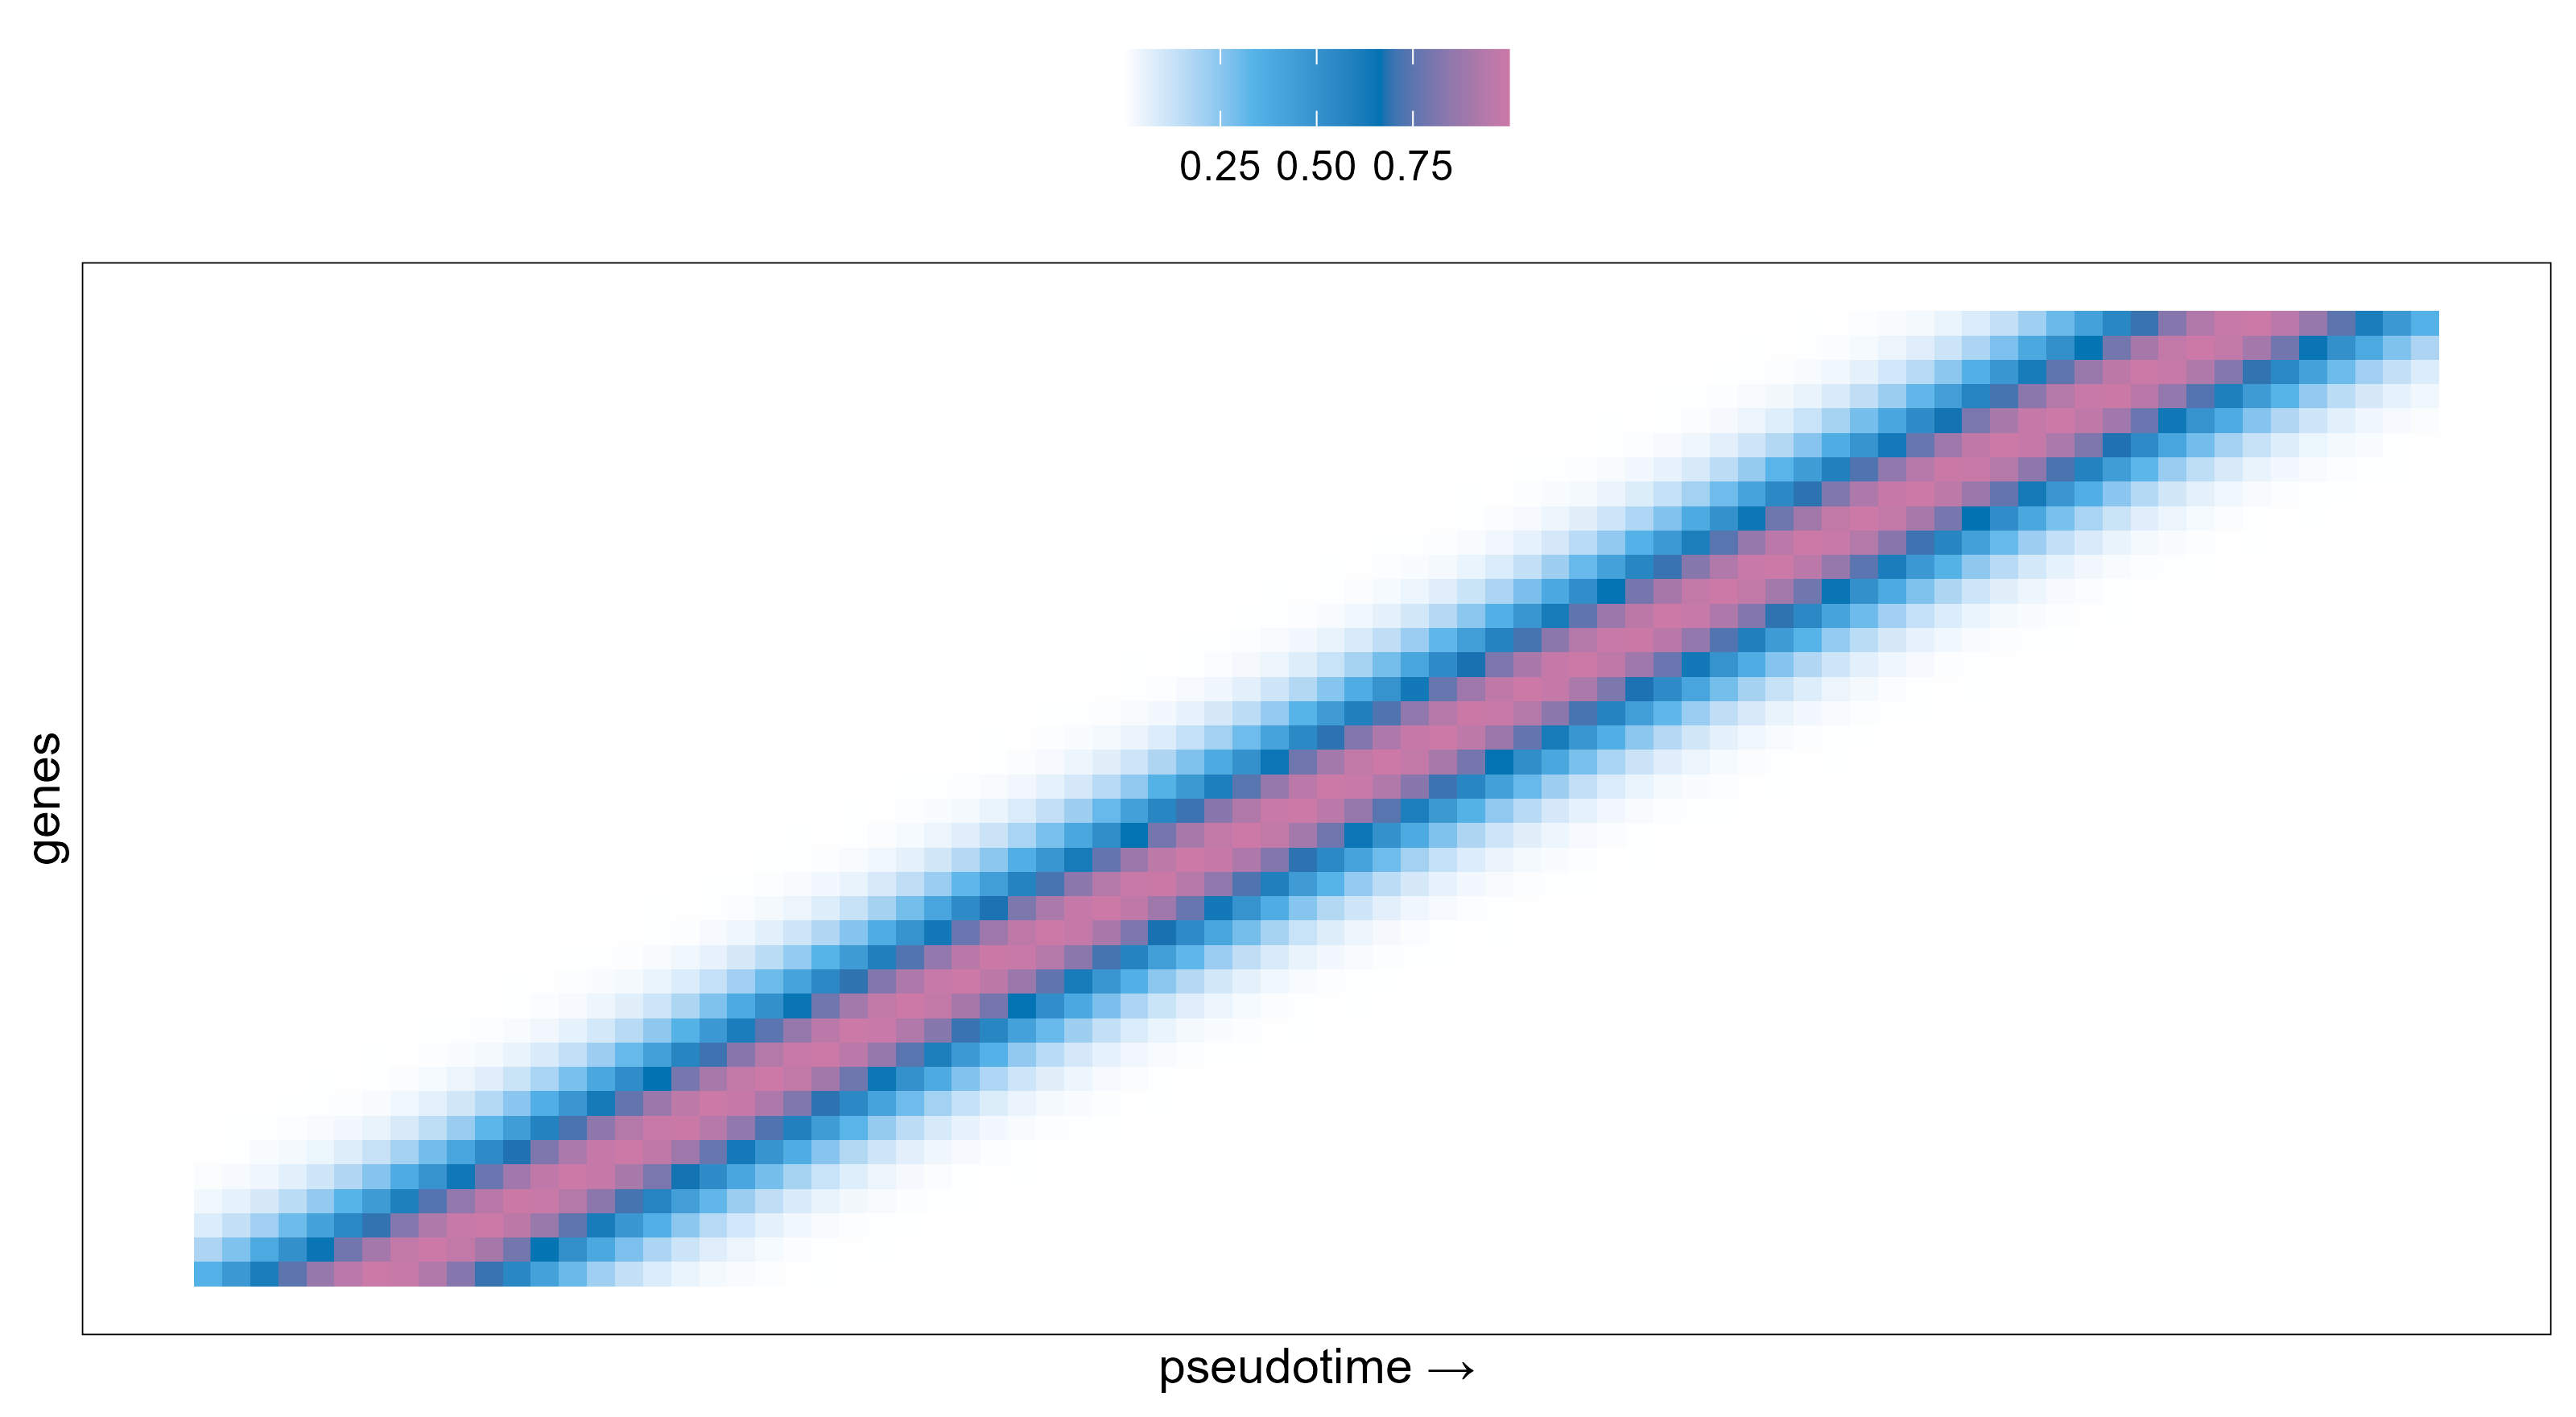
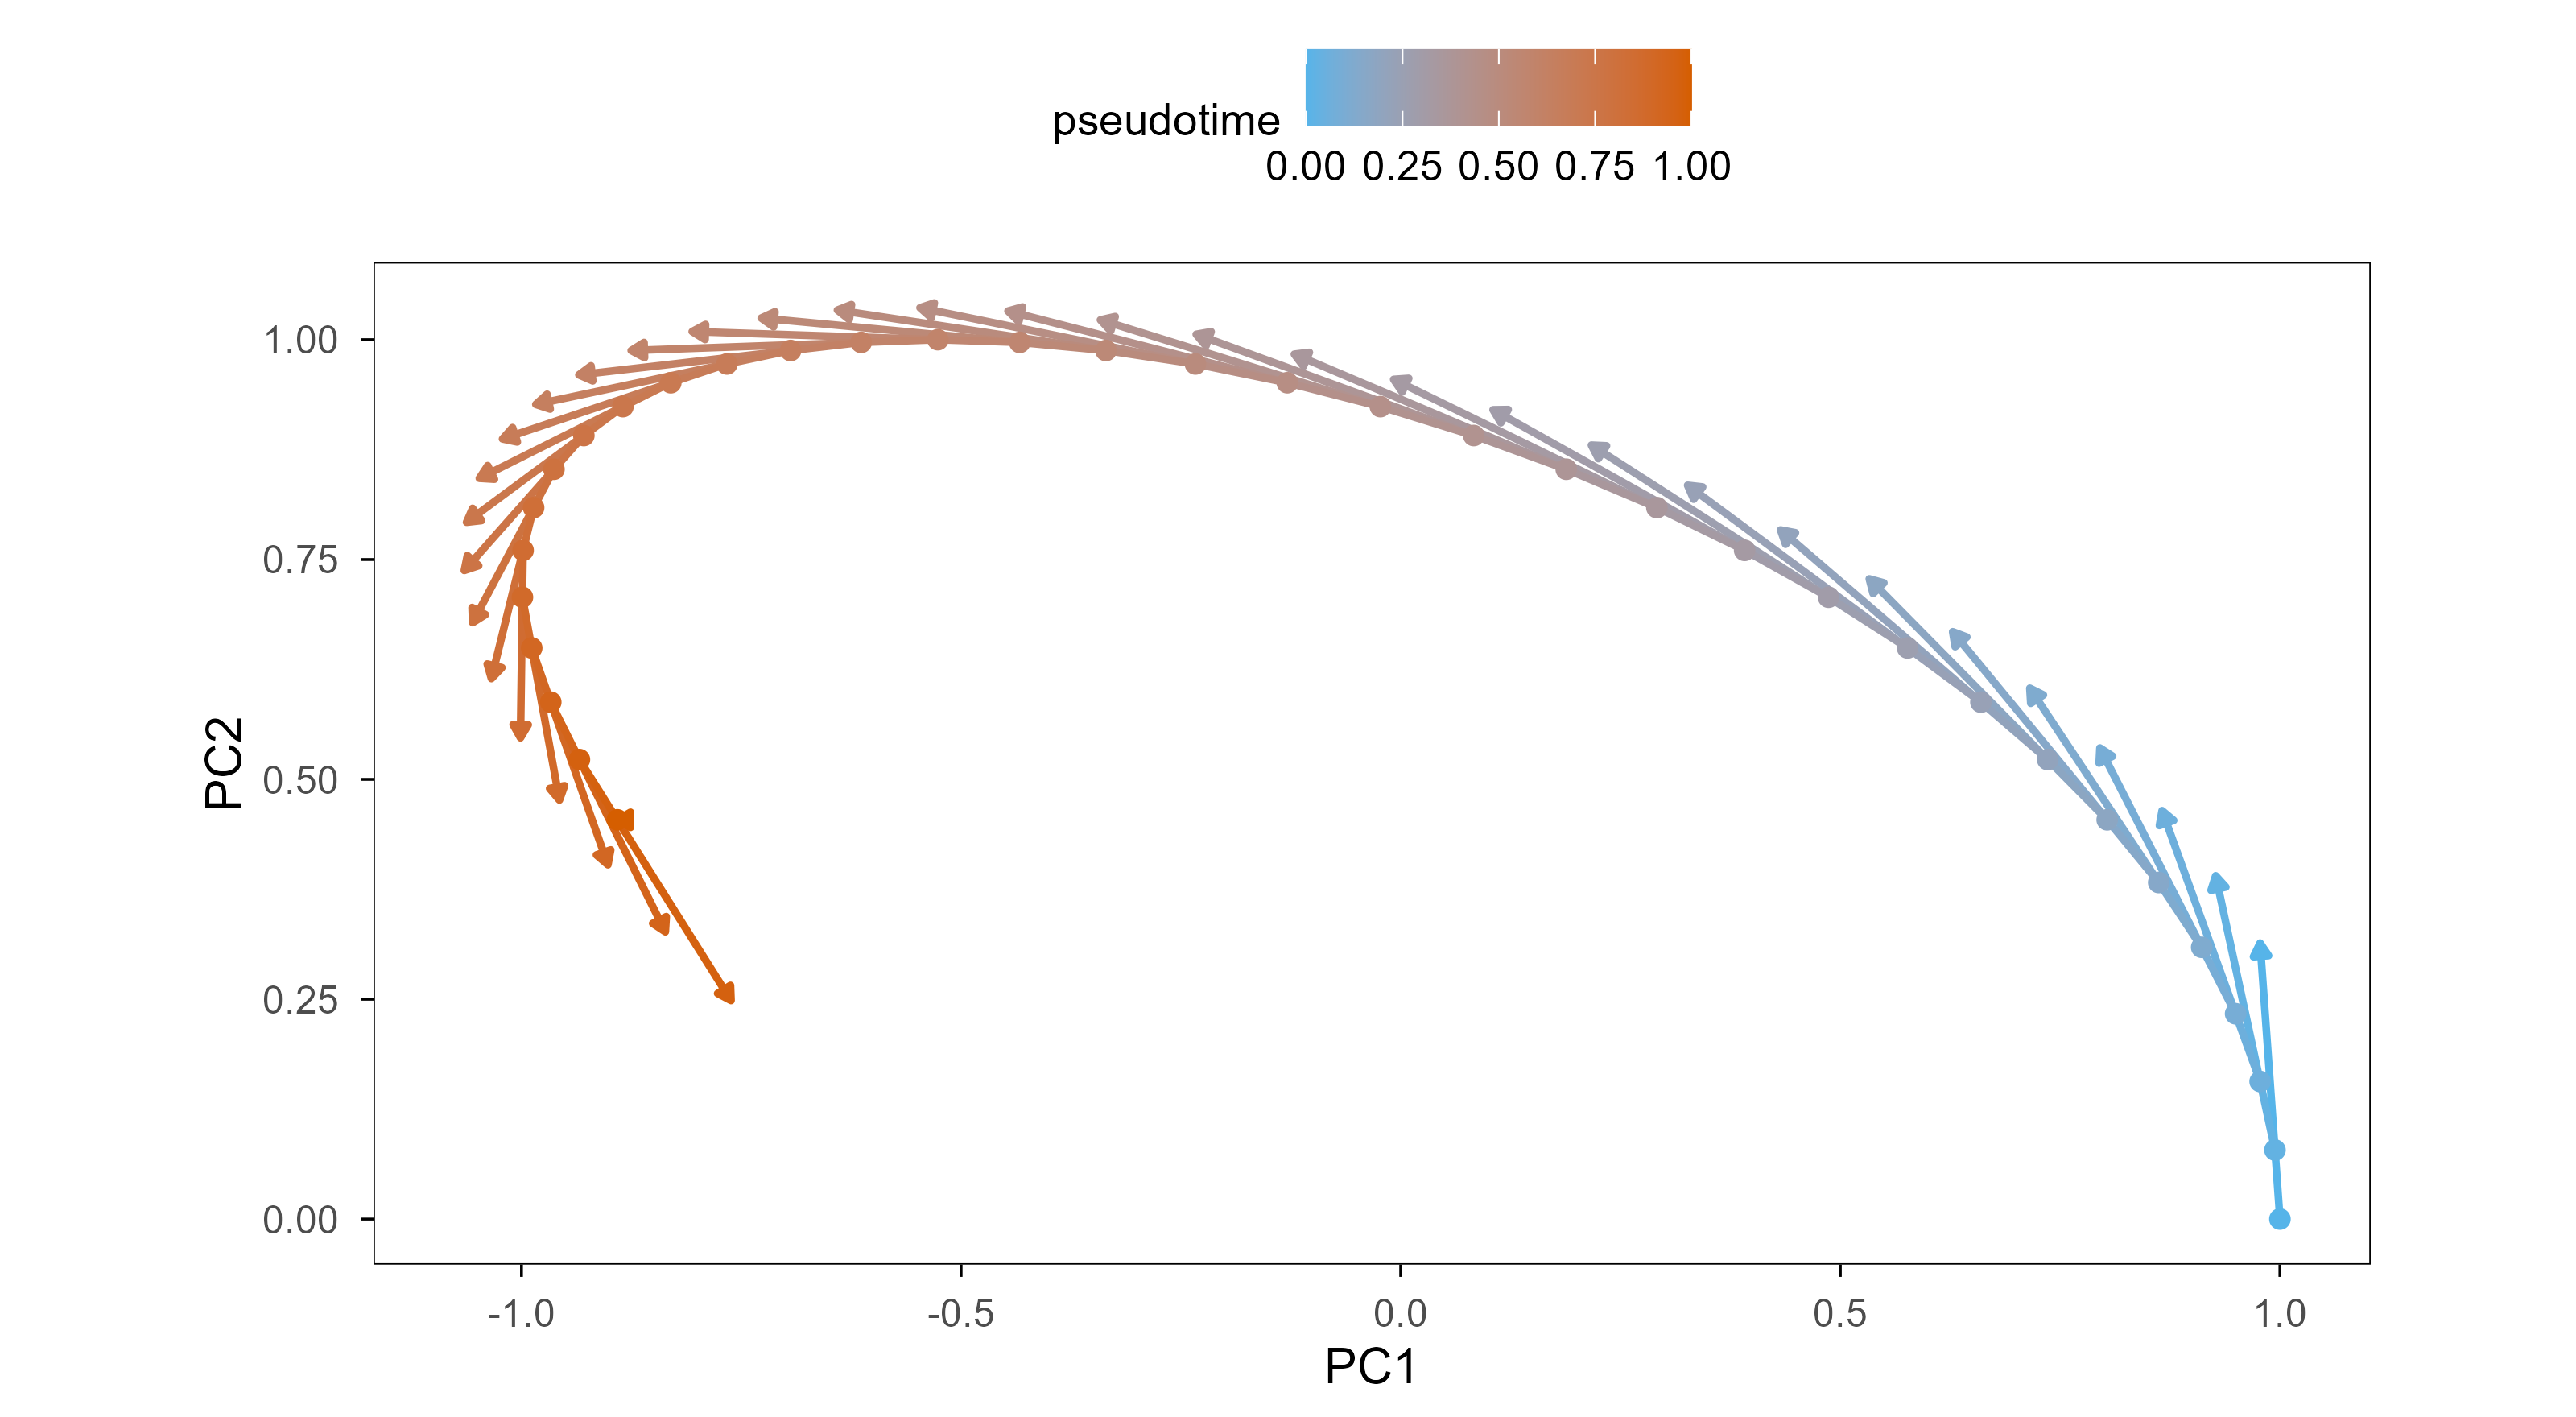
如果细胞来自一个分化过程,聚类得到的离散标签就不够用了。拟时序(pseudotime) 把细胞按表达相似性排到一条轨迹上,RNA velocity 则用未剪接/已剪接 reads 的比例预测每个细胞“下一步往哪走”。
set.seed (6 )<- 80 <- 40 <- seq (0 , 1 , length.out = n_cells)<- seq (0.08 , 0.92 , length.out = n_g)<- outer (peaks, t, function (p, tt) exp (- ((tt - p)^ 2 ) / (2 * 0.055 ^ 2 )))<- expand.grid (gene = 1 : n_g, cell = 1 : n_cells)$ expr <- as.vector (wave)ggplot (pt, aes (cell, gene, fill = expr)) + geom_tile () + scale_fill_gradientn (colours = c ("#FFFFFF" , "#56B4E9" , "#0072B2" , "#CC79A7" )) + labs (x = "pseudotime →" , y = "genes" , fill = NULL ) + theme (axis.text = element_blank (), axis.ticks = element_blank ())
<- seq (0 , 1 , length.out = 35 )<- cos (tt * pi * 1.15 )<- sin (tt * pi * 0.85 )<- data.frame (x = x, y = y, t = tt,vx = c (diff (x), 0 ), vy = c (diff (y), 0 )ggplot (vel, aes (x, y)) + geom_segment (aes (xend = x + vx * 4 , yend = y + vy * 4 , colour = t),arrow = arrow (length = unit (0.12 , "cm" ), type = "closed" ), linewidth = 0.8 + geom_point (aes (colour = t), size = 1.6 ) + scale_colour_gradient (low = blog_pal[["sky" ]], high = blog_pal[["vermillion" ]]) + coord_equal () + labs (x = "PC1" , y = "PC2" , colour = "pseudotime" )
需要强调的是:注释不是终点,而是下一轮分析的起点 。你得到的不是一个“答案”,而是一组带标签的细胞和一堆可以验证的假设。
13. 多组学、整合与空间
单细胞项目很少只做一个模态。常见的组合:
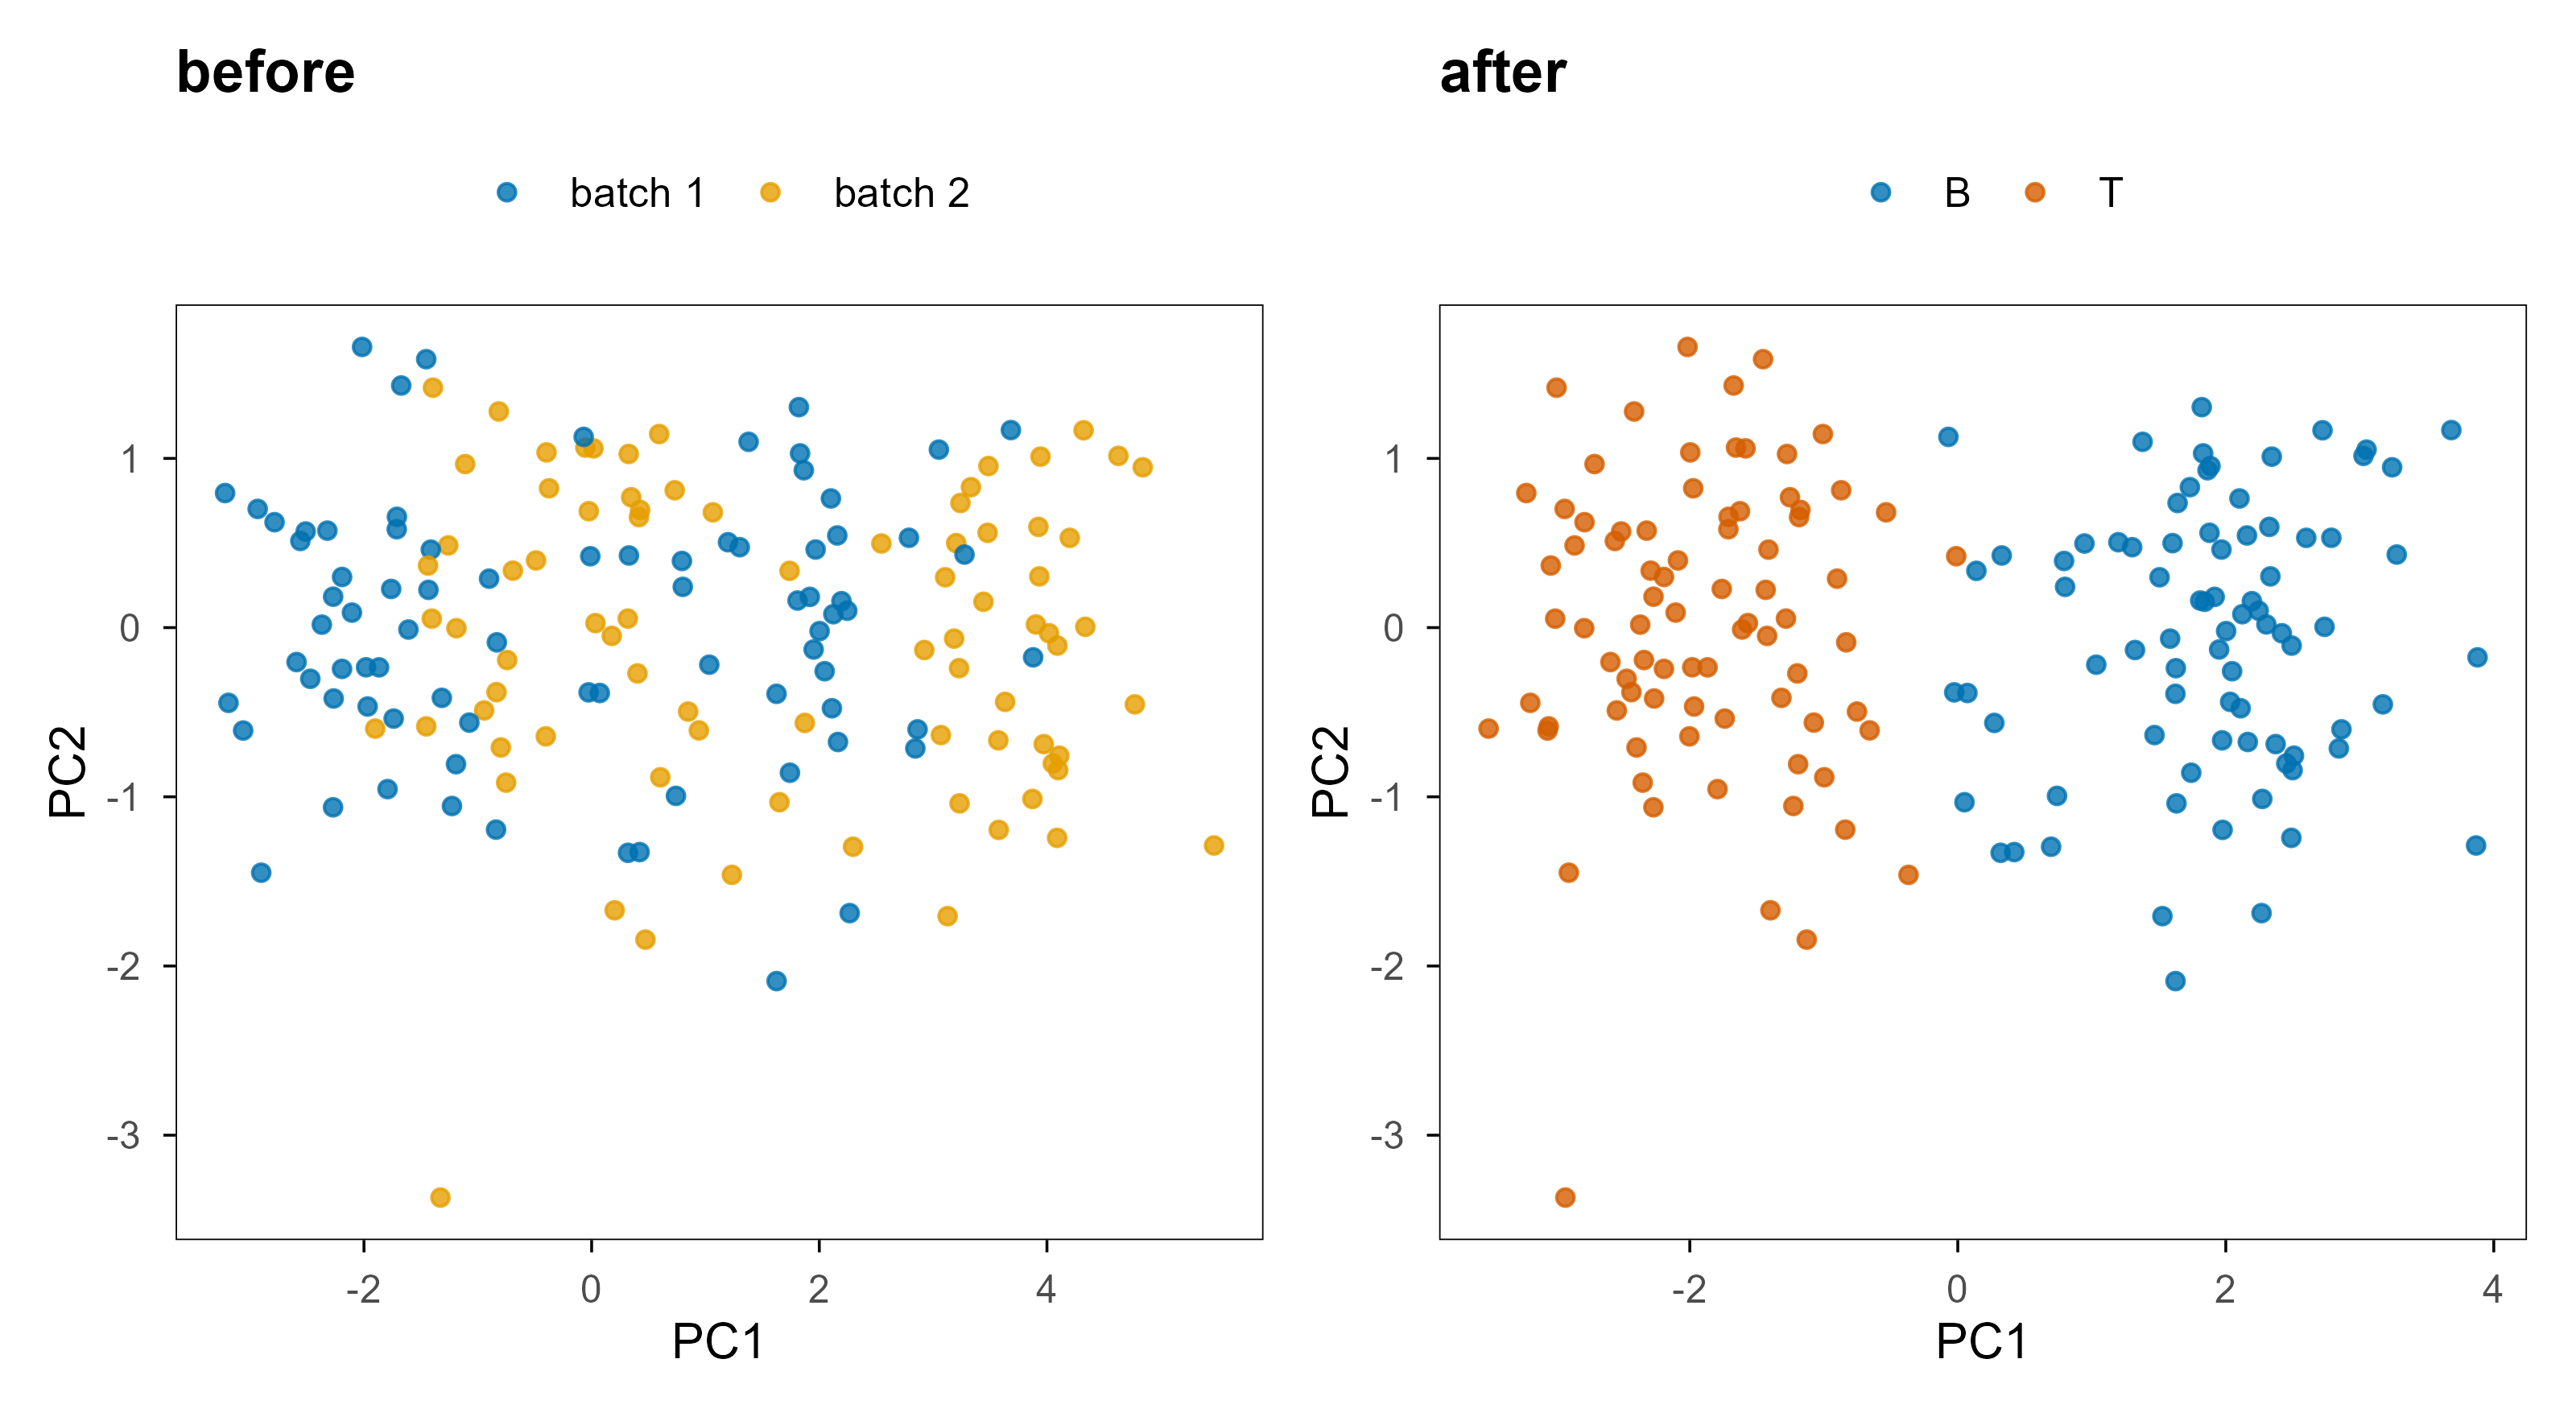
RNA + ATAC(10x Multiome) :同一批细胞核同时测表达和染色质可及性,用 WNN(weighted nearest neighbor)联合聚类,可以把“哪个 enhancer 驱动了哪个基因”放到同一个细胞里看。RNA + 蛋白(CITE-seq) :抗体标签(ADT)提供表面蛋白,常用来区分 T 细胞亚群、NK 亚群,或做样本 hashing。RNA + 空间(Visium / Xenium) :把单细胞图谱映射到组织切片,回答“这群细胞在哪个区域”。多样本整合 :Harmony、BBKNN、scVI、Seurat CCA/RPCA。整合的目标是去掉批次,不是把所有样本强行混在一起;如果生物学差异本身很大,过度整合会抹掉真实信号。
set.seed (15 )<- data.frame (x = c (rnorm (80 , - 2 , 0.8 ), rnorm (80 , 2 , 0.8 )),y = c (rnorm (80 , 0 , 0.8 ), rnorm (80 , 0 , 0.8 )),type = factor (rep (c ("T" , "B" ), each = 80 )),batch = factor (rep (c ("batch 1" , "batch 2" ), 80 ))$ x[demo$ batch == "batch 2" ] <- demo$ x[demo$ batch == "batch 2" ] + 1.6 <- ggplot (demo, aes (x, y, colour = batch)) + geom_point (size = 1.5 , alpha = 0.8 ) + scale_colour_manual (values = c (blog_pal[["blue" ]], blog_pal[["orange" ]])) + labs (title = "before" , x = "PC1" , y = "PC2" , colour = NULL )<- ggplot (demo, aes (x - ifelse (batch == "batch 2" , 1.6 , 0 ), y, colour = type)) + geom_point (size = 1.5 , alpha = 0.8 ) + scale_colour_manual (values = c (blog_pal[["blue" ]], blog_pal[["vermillion" ]])) + labs (title = "after" , x = "PC1" , y = "PC2" , colour = NULL )+ p2
14. 从 count matrix 到下一轮结果
单细胞项目的“下一轮”通常发生在五个方向:
差异表达 :某个基因在病人和对照的同一细胞类型里是否变化?推荐 pseudobulk + DESeq2/edgeR ,而不是把每个细胞当独立样本做 Wilcoxon(后者会给出极小的 p 值)。细胞比例 :某个细胞类型是否扩增或缺失?用 propeller、sccomp、scCODA 等考虑组成数据的模型,并按样本重复检验。细胞间通讯 :配体–受体共表达分析(CellChat、CellPhoneDB、NicheNet)推测哪群细胞在“对话”。多组学整合 :把 RNA 与 ATAC、蛋白、空间位置对齐(Harmony、scVI、TotalVI、WNN)。把状态映射回组织 :用参考图谱做 label transfer(Azimuth),或把单细胞图谱反卷积到空间转录组上。
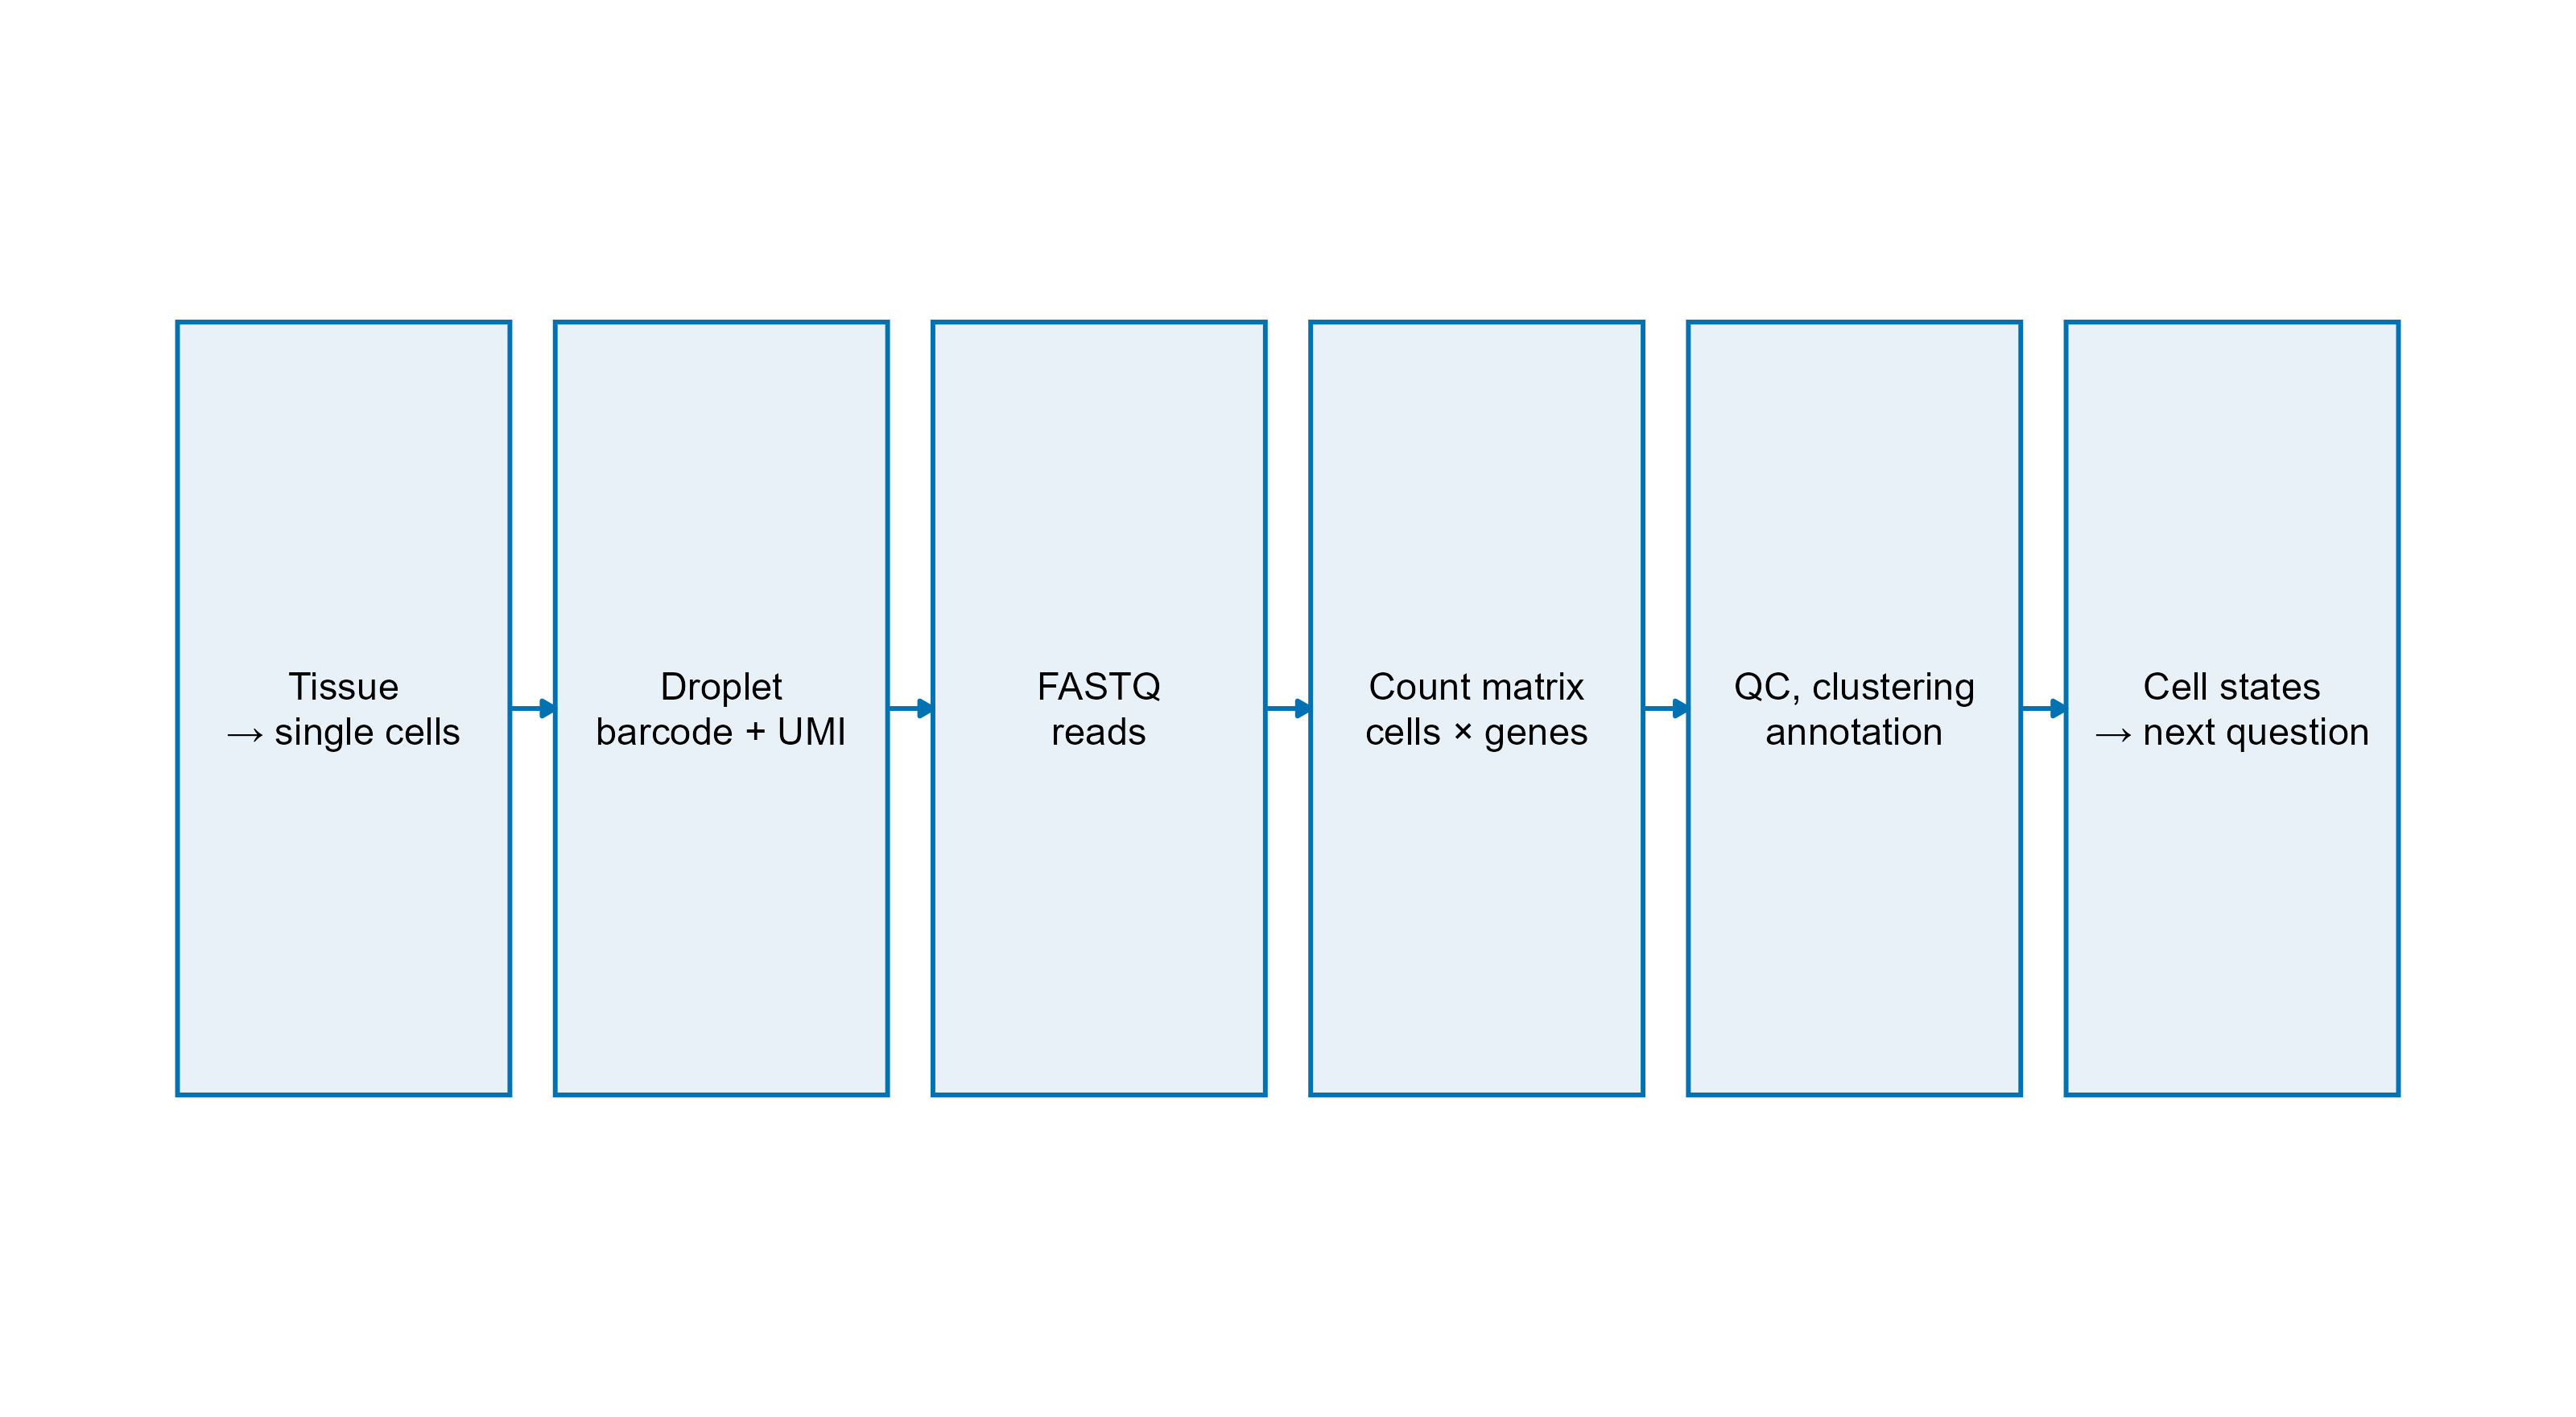
整条链路可以压缩成一张图:
<- data.frame (x = 1 : 6 ,label = c ("Tissue \n → single cells" , "Droplet \n barcode + UMI" , "FASTQ \n reads" ,"Count matrix \n cells × genes" , "QC, clustering \n annotation" , "Cell states \n → next question" ggplot (steps, aes (x = x, y = 0 )) + geom_rect (aes (xmin = x - 0.44 , xmax = x + 0.44 , ymin = - 0.3 , ymax = 0.3 ),fill = "#E8F1F8" , colour = blog_pal[["blue" ]], linewidth = 0.5 + geom_text (aes (label = label), size = 3 , lineheight = 1 ) + geom_segment (data = data.frame (x = 1 : 5 ),aes (x = x + 0.44 , xend = x + 0.56 , y = 0 , yend = 0 ),arrow = arrow (length = unit (0.12 , "cm" ), type = "closed" ),colour = blog_pal[["blue" ]]+ coord_cartesian (xlim = c (0.4 , 6.6 ), ylim = c (- 0.5 , 0.5 )) + theme_void ()
15. 常见坑与检查清单
分析前
参考基因组版本、试剂盒版本、链方向是否一致?
是否有生物学重复?批次是否平衡?
空液滴阈值是否按样本检查过?
分析中
是否做 doublet 检测?doublet 是否被当成新类型?
是否检查 ambient RNA?高丰度污染基因是否驱动了聚类?
过滤阈值是否过严?是否丢掉了低 RNA 含量的真实细胞?
HVG 数量、PC 数、Leiden 分辨率是否做过敏感性分析?
整合是否过度?批次和生物学是否被混为一谈?
解释时
是否用 pseudobulk 做差异表达?
细胞比例变化是否按样本重复检验?
marker 是否独立验证?是否循环论证?
UMAP 距离/面积是否被当作生物学差异?
结论是否能被第二个数据集、蛋白或空间数据支持?
16. 术语表
Cell barcode
16 bp 细胞标签,标识一个液滴/细胞
UMI
分子标签,用于去除 PCR 重复
Whitelist
平台预设的合法条码列表
Empty droplet
不含细胞、只有背景 RNA 的液滴
Ambient RNA
空液滴中的游离 RNA,会污染真细胞
Doublet
两个细胞进入同一个液滴
Count matrix
基因 × 细胞的 UMI 计数矩阵
HVG
高变基因,用于降维
Pseudobulk
把同一细胞类型的细胞计数相加成样本级表达
Label transfer
把参考图谱的细胞类型标签映射到新数据
Pseudotime
按表达相似性推断的细胞顺序
RNA velocity
用剪接比例预测细胞状态变化方向
17. 参考
10x Genomics. Chromium Single Cell 3’ Reagent Kits User Guide
Zheng et al. (2017). Massively parallel digital transcriptional profiling of single cells. Nature Communications .
Kaminow et al. (2021). STARsolo: accurate, fast and versatile mapping/quantification of single-cell and single-nucleus RNA-seq data. bioRxiv .
Lun et al. (2019). EmptyDrops: distinguishing cells from empty droplets in droplet-based single-cell RNA sequencing data. Genome Biology .
Hao et al. (2021). Integrated analysis of multimodal single-cell data. Cell (Seurat v4).
Wolf et al. (2018). SCANPY: large-scale single-cell gene expression data analysis. Genome Biology .
Cao et al. (2019). The single-cell transcriptional landscape of mammalian organogenesis. Nature (Monocle 3).
Bergen et al. (2020). Generalizing RNA velocity to transient cell states through dynamical modeling. Nature Biotechnology .
Jin et al. (2021). CellChat: inference and analysis of cell-cell communication. Nature Communications .
Virshup et al. (2023). The scverse project provides a computational ecosystem for single-cell omics data analysis. Nature Biotechnology .